- Що таке ШІ-скрапінг
- Які наслідки ШІ-скрапінгу для сайту
- Як перевірити наявність ШІ-скрапінгу на сайті
- Як зменшити навантаження від ШІ-скрапінгу
- Чи можливо повністю зупинити шкідливий ШІ-скрапінг
Ви слідкуєте за інтернет-проектом: оптимізуєте бази даних, стискаєте зображення, видаляєте зайвий код. Кількість відвідувачів збільшується, але раптом ви помічаєте, що сервер починає видавати помилку або отримуєте лист від провайдера про перевищення лімітів. Хоча відразу хочеться звинуватити себе в недостатній оптимізації, але причина може бути в недостатньому захисті сайту від ШІ-скрапінгу. Поки ви вкладаєте максимум зусиль у створення контенту та технічні покращення, хтось за секунду краде ваші матеріали, ще й призводить до аномальних навантажень. Я перевірив це на власному веб-ресурсі й покажу, як знайти таких ботів та обмежити їх без шкоди для SEO та GEO.
Що таке ШІ-скрапінг
ШІ-скрапінг — це автоматичний збір вмісту сайтів системами штучного інтелекту. Це можуть робити як великі ШІ-компанії на кшталт OpenAI та Anthropic, які навчають моделі, формують відповіді в пошуку й відкривають сторінки на запит користувача, так і анонімні скрапери, що маскуються під звичайний браузер.
ШІ-скрапінг не варто плутати з класичним парсингом сайтів, який збирає конкретні дані, наприклад, ціни конкурента. Натомість боти штучного інтелекту обходять весь веб-ресурс, включно зі старими статтями й архівами, через що навантажують сервер інакше, ніж живі відвідувачі.
Які наслідки ШІ-скрапінгу для сайту
Основні наслідки ШІ-скрапінгу для сайту — перевантаження хостингу, контент без зворотного трафіку та копії ваших матеріалів на чужих ресурсах.
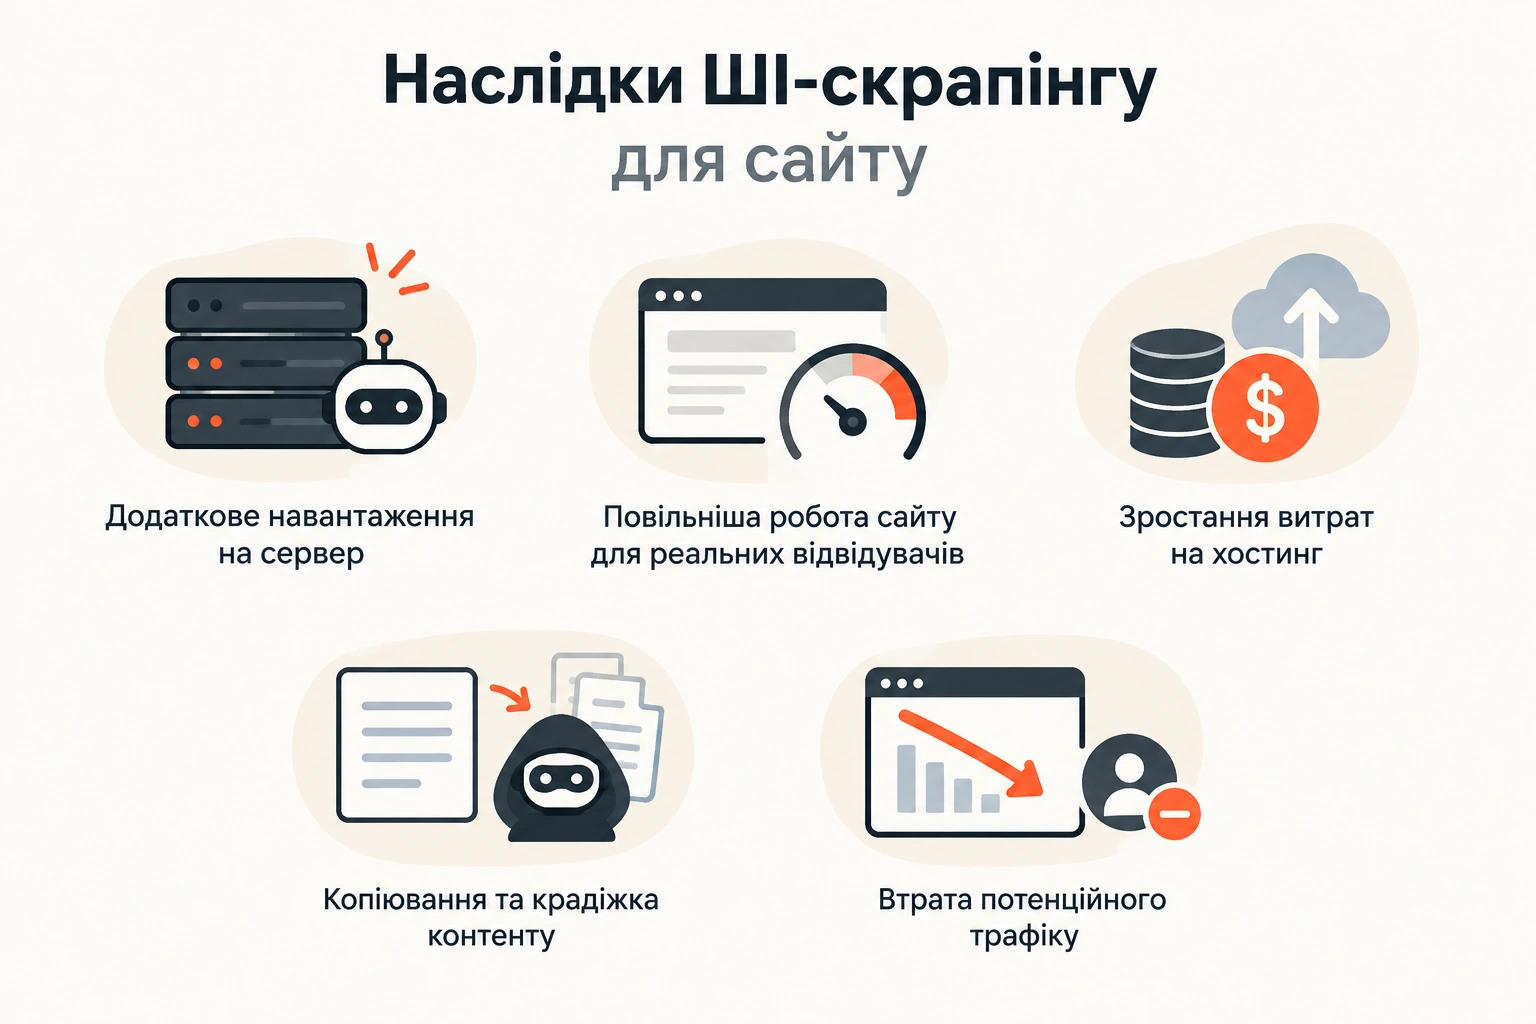
Кожен наслідок має важливе значення для інтернет-проекту будь-якого розміру:
- Навантаження на хостинг. Людина відкриває кілька сторінок та читає кожну по кілька хвилин, а бот за годину може переглянути тисячі адрес, включно зі старими й технічними, яких немає в кеші. Сервер щоразу запускає PHP та звертається до бази даних, тож сайт сповільнюється для живих відвідувачів або взагалі перестає відкриватися.
- Контент без зворотного трафіку. ШІ-системи забирають тексти значно частіше, ніж приводять читачів. За даними TollBit, європейські видавці отримують приблизно 179 візитів ШІ-ботів на один перехід живого користувача.
- Копіювання контенту. Видання The Media Copilot переказало звіт TollBit, де описано майже 40 сервісів, які продають послуги скрапінгу: багато з них за замовчуванням ігнорують robots.txt, а деякі обходять навіть платний доступ. В результаті ваш контент опиняється на чужих веб-ресурсах і може ранжуватися там навіть краще.
Ви можете подумати, що вашому невеликому сайту нічого не загрожує, але боти не шукають конкретні веб-ресурси, а обробляють списки адрес. Пошукові боти знаходять сторінки за посиланнями та картами сайту. Common Crawl щомісяця обходить понад 2 мільярди сторінок для відкритих архівів, на яких навчають мовні моделі. А скраперам вистачає публічних журналів SSL-сертифікатів, щоб знайти новий домен за кілька хвилин.
Наприкінці липня 2026 року власник невеликої вікі описав на Medium, як бот meta-webindexer за півтори доби зробив 230 743 запити до сайту з 4 814 статтями. Старі версії та сторінки редагування перетворили кілька тисяч статей на сотні тисяч адрес, 98% запитів ішли на заборонені в robots.txt сторінки, а бот забрав 47% вихідного трафіку, і рахунок за хмарний сервер приблизно подвоївся.
Як перевірити наявність ШІ-скрапінгу на сайті
Щоб перевірити ШІ-скрапінг, зіставте три джерела: графік навантаження в панелі хостингу, кількість живих відвідувачів у Google Analytics і журнал запитів до сайту. Про ШІ-скрапінг можна говорити, лише коли піки навантаження збігаються в часі із серіями запитів конкретних ШІ-ботів.
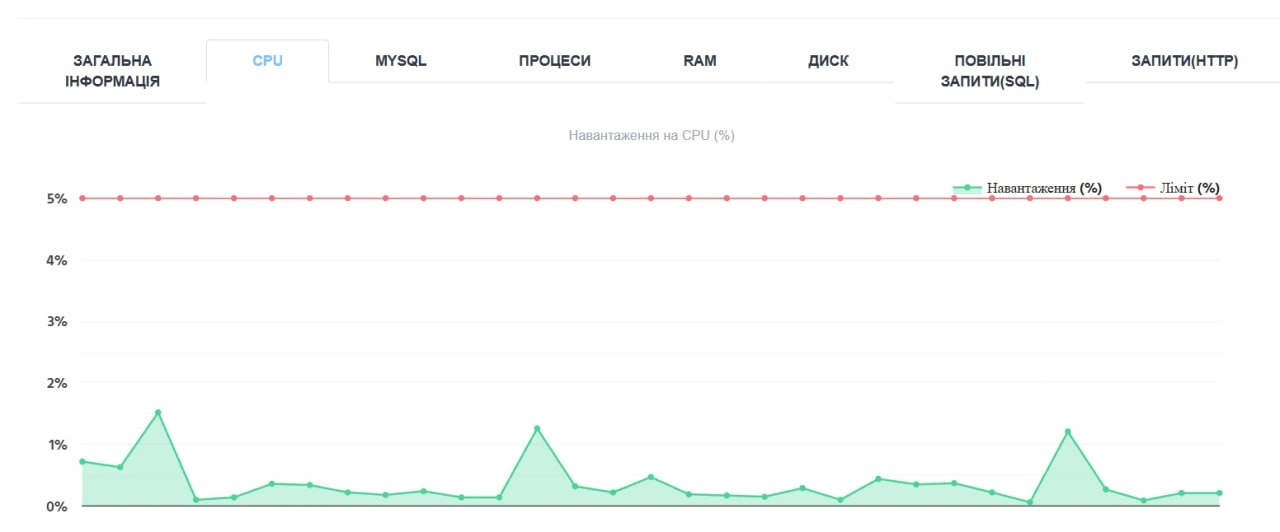
На скриншоті графік навантаження хостингу одного з проектів на Cityhost (опубліковано за згодою власника).
Тож спочатку знайдіть піки навантаження:
- Відкрийте панель Cityhost → Хостинг 2.0 → Керування → Ресурси.
- Перейдіть на вкладку CPU та виберіть найдовший доступний період.
- Запишіть дату й годину кожного моменту, коли графік упирався в ліміт.
На моєму сайті за тиждень процесор кілька разів досягав ліміту 100%, хоча середнє навантаження становило 40%. Тож після цього порівняйте такі навантаження з кількістю реальних відвідувачів на вашому веб-ресурсі за цей же період:

- Відкрийте Google Analytics 4 → Дослідити → Free form.
- Виставте період, що охоплює ваші піки.
- Додайте параметр «Дата й час (РРРРММДДГГ)» у «Рядки», а показник «Сеанси» — у «Значення».
- Знайдіть у таблиці години ваших піків.
GA4 автоматично виключає відомих ботів, а більшість інших не виконують JavaScript, тож лічильник бачить лише людей. Якщо навантаження стрибнуло, а сесій не додалося, причина в ботах або фонових процесах сайту. У мене за тиждень GA4 нарахував лише 18 сесій, тоді як сервер отримав 32 918 запитів.
Важливо! Звірте часові пояси: панель хостингу, GA4 та журнал запитів можуть показувати час у різних поясах. У моєму випадку різниця між журналом і панеллю становила 4 години.
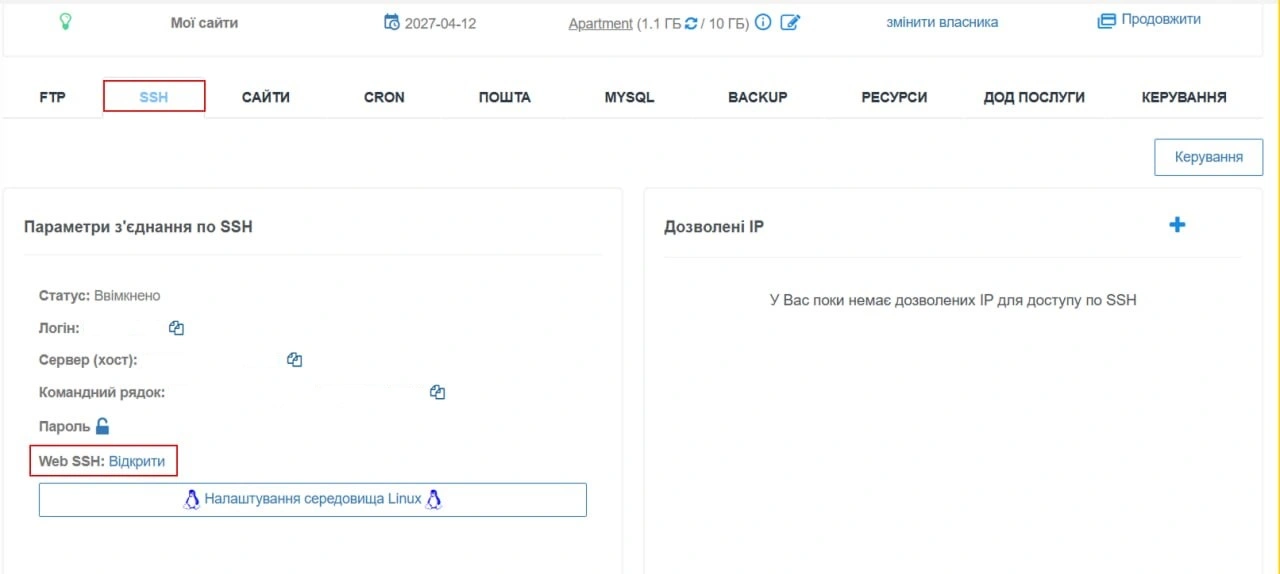
Потім з'ясуйте, хто робить запити. У Cityhost журнал зручно аналізувати інструментом GoAccess, який запускається через Хостинг → Керування → SSH → Web SSH → «Web SSH: Відкрити». Покрокова інструкція є на сторінці «Аналіз логів доступу з допомогою GoAccess».

Нам потрібен розділ 6 — Operating Systems. Перейдіть до нього, натиснувши цифру 6 на клавіатурі, і потім натисніть Enter, щоб відкрити дані. Відсоток запитів від ботів та їхні назви можна подивитися у рядку «Crowlers».
На скриншоті GoAccess за 5 жовтня зафіксовано 3304 запити до сайту, з яких 596, або 18,04%, потрапили до категорії «Crawlers». Однак вважати всі ці звернення активністю ШІ-скраперів не можна: у видимій частині списку немає назв GPTBot, ClaudeBot чи PerplexityBot, натомість показані GoogleApp, GoogleMobile, CFNetwork, TwitterBot і facebookexternalhit. Сама категорія «Crawlers» не визначає, чи пов’язаний запит зі збиранням даних для штучного інтелекту. Окремої уваги потребує «Unknown»: на цю категорію припадає 657 запитів, або 19,88%, але її назва також не дає змоги встановити їхнє походження. Отже, цей фрагмент звіту не підтверджує активності ШІ-скраперів і не виключає її — для висновку потрібно перевірити повний список User-Agent у логах.
Пошукаємо ШІ-ботів безпосередньо у файлі логів через це ж SSH-вікно:
- Перемкніть клавіатуру на англійську та натисніть q, щоб вийти з GoAccess. Саме SSH-вікно залиште відкритим.
- Вставте цю команду й натисни Enter (замість MYSITE_NAME підставте свій домен):
awk -F'"' 'tolower($6) ~ /gptbot|oai-searchbot|chatgpt-user|claudebot|claude-searchbot|claude-user|perplexitybot|perplexity-user|meta-externalagent|meta-externalfetcher|meta-webindexer|bytespider|ccbot|amazonbot/ {print $6}' /var/www/ch50e2c72b/logs/MYSITE_NAME.access.log | sort | uniq -c | sort -nr

У команді ми шукали 14 назв ботів та User-Agent:
- OpenAI: GPTBot, OAI-SearchBot, ChatGPT-User.
- Anthropic: ClaudeBot, Claude-SearchBot, Claude-User.
- Perplexity: PerplexityBot, Perplexity-User.
- Meta: meta-externalagent, meta-externalfetcher, meta-webindexer.
- Інші: Bytespider, CCBot, Amazonbot.
Пошук у повних User-Agent дав точніший результат, ніж загальна категорія «Crawlers» у GoAccess: у перевіреному файлі логів знайдено лише один запит із назвою OAI-SearchBot — пошукового бота OpenAI. Інших перелічених ШІ-ботів команда не виявила. Отже, ці дані не свідчать про масове сканування сайту ШІ-скраперами, а частку «Crawlers» у звіті не можна прирівнювати до їхньої активності.
Тож саме перевірка наявності ШІ-скрапінгу є одним з найважливіших етапів. Якщо у вас така сама ситуація, то вам навіть не треба витрачати час на боротьбу зі скрапінгом штучного інтелекту, а достатньо грамотно оптимізувати сайт.
Як зменшити навантаження від ШІ-скрапінгу
Приберіть зайві фонові задачі та активуйте кешування, обмежте обхід сумлінних ботів через robots.txt, а тих, хто не дотримується правил, сповільніть або заблокуйте на рівні сервера, Wordfence чи Cloudflare. Повністю захиститися від ШІ-скрапінгу неможливо, але ці методи допомагають хоча б зменшити навантаження на хостинг сайту.
- Приберіть зайві фонові задачі
- Увімкніть кешування сторінок
- Сповільніть занадто активних ботів у Wordfence
- Внесіть правила проти ШІ-скрапінгу в robots.txt
- Заблокуйте ботів на рівні сервера
- Увімкніть заборону навчання в Cloudflare
Приберіть зайві фонові задачі
WordPress запускає фонові задачі через WP-Cron, який за замовчуванням перевіряє їх при кожному завантаженні сторінки. Тож кожен запит бота теж може запустити черговий цикл задач. На моєму сайті такі задачі давали 14% усіх запитів: плагін Link Whisper кожні 5 хвилин перевіряв биті посилання, а черга Action Scheduler запускалася щохвилини.

Тож раджу:
- Встановити плагін WP Crontrol.
- Відкрити Tools → Cron Events.
- Знайти задачі, які запускаються щохвилини або кожні кілька хвилин.
- У колонці Action за назвою функції визначити плагін, наприклад Wpil належить Link Whisper.
В результаті виберіть ці плагіни та вимкніть їх, якщо не користуєтеся, або обмежте їх роботу через налаштування кожного конкретного розширення.
Увімкніть кешування сторінок
Кешування зберігає вже згенеровану сторінку як готовий файл. Коли бот чи людина запитує її повторно, сервер не запускає PHP та не звертається до бази даних, а просто віддає файл. На моєму сайті для цього працює плагін LiteSpeed Cache.

Проти ШІ-ботів кеш працює гірше, ніж проти людей. Люди здебільшого читають популярні сторінки, які вже є в кеші, а ШІ-краулери обходять весь сайт, включно зі старими статтями, куди давно ніхто не заходив. Однак вони сканують всі сторінки, тож ті, що вже знаходяться в кеші, все одно допоможуть зменшити навантаження на віртуальний хостинг краще, ніж взагалі відсутність кешування на веб-ресурсі.
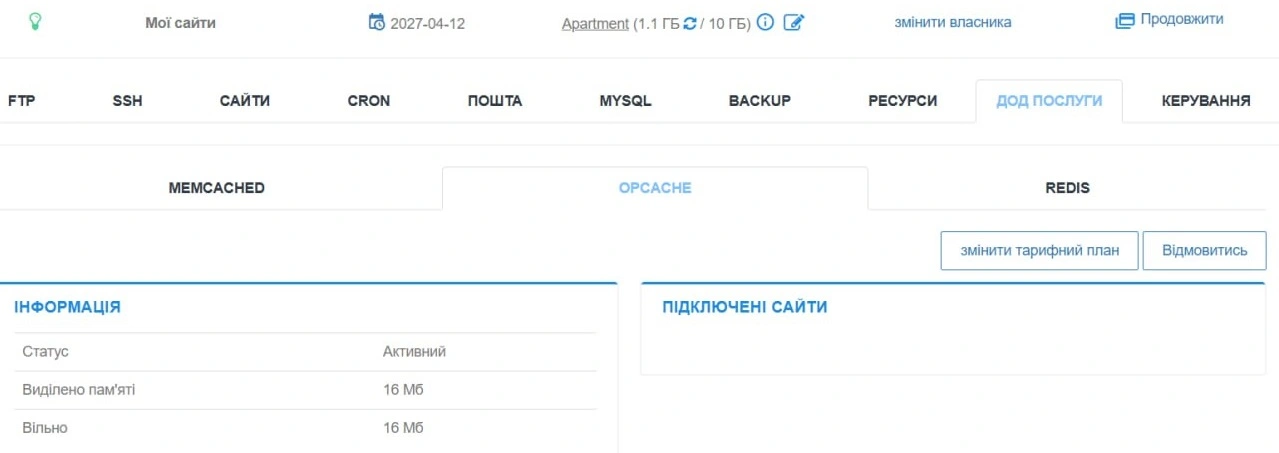
OPcache — це інший вид кешу, який зберігає скомпільований PHP-код, щоб сервер не перечитував файли WordPress при кожному запиті. Він прискорює генерацію сторінок, але не замінює їх кеш, бо PHP та база даних однаково працюють. У Cityhost OPcache підключається в панелі керування через Керування → Додаткові послуги → OPcache. Для сайтів із частими зверненнями до бази даних Cityhost також пропонує Memcached та Redis, які вони зберігають у пам'яті результати запитів до бази.
Читайте також: Сервіси кешування для сайтів: Memcached, OPCache, Redis
Сповільніть занадто активних ботів у Wordfence
Безкоштовна версія плагіна Wordfence, якою я користуюся вже 2 роки, вміє обмежувати частоту запитів:
- Відкрийте Wordfence → All Options → Firewall Options → Rate Limiting.
- Перевірте, чи увімкнено Enable Rate Limiting and Advanced Blocking.
- Задайте 240 запитів на хвилину для If anyone's requests exceed.
- Задайте 120 для обох правил page views і 60 для обох правил 404s.
- Для кожного правила оберіть Throttle it і збережіть зміни.

Це стартові значення, які радить підтримка Wordfence. Throttle означає, що бот, який перевищив ліміт, тимчасово отримує відповідь 503, доки не зменшить частоту запитів. Пошукові системи розуміють таку відповідь, тому Wordfence радить обирати саме цю дію. Ліміти для людей теж важливі, бо скрапери, що маскуються під браузер, потрапляють у цю категорію. Також переконайтеся, що в How should we treat Google's crawlers обрано Verified Google crawlers will not be rate-limited.
Важливо! Обмеження частоти зупиняє різкі сплески, а не повільних сканерів. На моєму сайті сканер робив близько 10 запитів на хвилину й жодного ліміту не перевищив.
Внесіть правила проти ШІ-скрапінгу в robots.txt
robots.txt — це прохання до ботів, а не жорстке правило: за даними TollBit, у четвертому кварталі 2025 року ШІ-скрапери проігнорували його заборони в 30% запитів. Проте пошукові й навчальні боти великих компаній здебільшого дотримуються цих правил. Я розділив ботів на дві групи: тим, що приводять читачів через ШІ-пошук, дозволив доступ, а тим, що збирають контент для навчання моделей, заборонив.
Ви можете відредагувати robots.txt через панель керування хостингом або SEO плагіни, наприклад, Rank Math SEO. До свого документу, саме стосовно ботів, я додав наступні рядки:
User-agent: *

Content-Signal: search=yes, ai-train=no, ai-input=yes

User-agent: OAI-SearchBot

User-agent: ChatGPT-User

User-agent: Claude-SearchBot

User-agent: Claude-User

User-agent: PerplexityBot

User-agent: Applebot

User-agent: DuckAssistBot

User-agent: MistralAI-User

Allow: /

User-agent: GPTBot

User-agent: ClaudeBot

User-agent: Google-Extended

User-agent: Google-CloudVertexBot

User-agent: Applebot-Extended

User-agent: Bytespider

User-agent: CCBot

User-agent: Amazonbot

User-agent: FacebookBot

User-agent: meta-externalagent

Disallow: /
Рядок Content-Signal повідомляє, що контент можна використовувати для пошуку та відповідей ШІ, але не для навчання моделей. Розміщуйте його в групі User-agent: * поруч із наявними правилами WordPress.
Важливо! Google-Extended не впливає на пошук Google та AI Overviews, але одне правило охоплює і навчання Gemini, і його відповіді з посиланнями на джерела. Тож, забороняючи його, ви втрачаєте й цитування в Gemini. Якщо видимість у Gemini для вас важливіша за захист від навчання, перенесіть Google-Extended у групу Allow.
Дозвіл у robots.txt не допоможе, якщо бота блокує захист сервера. У моїх логах дозволені OAI-SearchBot та PerplexityBot отримували відмову 403 приблизно в третині запитів. Тож після змін перевірте в журналі, яку відповідь отримують пошукові ШІ-боти. Якщо це саме 403, зверніться в підтримку хостингу, щоб додати їх у виключення.
Заблокуйте ботів на рівні сервера
Якщо бот ігнорує robots.txt, заблокуйте його на рівні сервера: тоді він отримує відповідь 403 ще до запуску WordPress. Спершу перевірте журнал, бо на моєму сайті GPTBot та CCBot уже отримували 403 без жодних моїх правил.
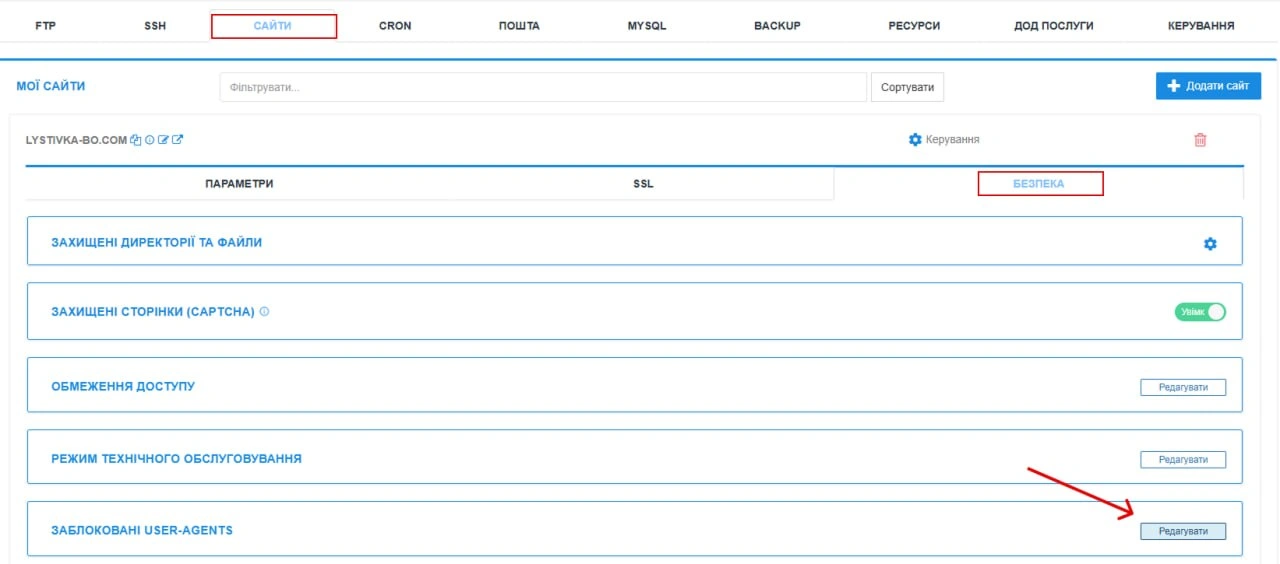
Для цього:
- Відкрийте cp.cityhost.ua → вкладка «Сайти».
- У потрібного сайту перейдіть на вкладку «Безпека».
- У розділі «Заблоковані User-Agents» натисніть «Редагувати».
- Додайте в кінець списку назву бота й збережіть зміни.
Cityhost уже блокує за замовчуванням поширених шкідливих ботів. Перевірити, чи спрацювало блокування, можна в Web SSH командою curl -I "https://ваш-сайт.com" -A "CCBot": у відповіді має бути код 403.
Важливо! Не додавайте до списку Googlebot, bingbot і пошукових ШІ-ботів, інакше сайт втратить трафік із пошуку та видимість у відповідях ШІ. А скраперів, що маскуються під браузер, блокування за User-Agent не зупинить.
Читайте також: Погані боти: чим вони шкодять сайту і як їх заблокувати
Увімкніть заборону навчання в Cloudflare
Cloudflare зупиняє ботів ще до того, як вони дійдуть до хостингу, а потрібні інструменти є на безкоштовному тарифі, яким я користуюся вже 1.5 роки:

- Додайте сайт у Cloudflare й змініть NS-сервери домену на ті, які він видасть.
- Відкрийте свій домен → Security → Settings.
- У фільтрі груп оберіть Bot traffic.
- Натисніть Configure AI bot policies.
- Для Training оберіть Disallow, а для Search та Agent залиште Allow (do not block).
- Натисніть Save.
Опція Disallow блокує навчальних ботів Amazon, Anthropic, Meta та OpenAI, а Googlebot, Applebot та Bingbot продовжують індексувати сайт для пошуку.

Перемикач Enable Bot Preference Sync додає правила Cloudflare на початок robots.txt. Якщо ви вже заборонили Google-Extended та Applebot-Extended у власному robots.txt, як описано вище, залиште його вимкненим, щоб правила не дублювалися.
Важливо! З 15 вересня 2026 року опції Block та Block on pages with ads для Training зупиняють також Googlebot, Bingbot та Applebot. Тож для заборони навчання обирайте саме Disallow.
Чи можливо повністю зупинити шкідливий ШІ-скрапінг
Ні. Частина ботів маскується під звичайних відвідувачів, і на невеликому сайті розпізнати всіх неможливо. Cloudflare описав, як Perplexity після блокування переходив на User-Agent браузера Chrome та змінював IP-адреси, а виявити це вдалося лише після дослідження на даних з мільйонів сайтів. Однак описані методи все ж дозволяють позбутися більшу частину ботів.
Тільки не поспішайте з діями. Мій тест показав, що страх перед ШІ-скрапінгом часто більший за реальну шкоду: ШІ-боти дали лише 3.2% запитів, а процесор перевантажували сканери вразливостей та фонові задачі WordPress. Тому не блокуйте всіх підряд. Спершу знайдіть, що саме навантажує ваш хостинг, і вирішуйте конкретно цю проблему, а ШІ-ботів обмежуйте лише тоді, коли знайдете саме їх в логах. І перевіряйте журнал запитів хоча б раз на місяць, щоб вчасно помітити нових ботів.