Ми всі можемо згадати кілька масштабних збоїв, які нас торкнулися. Вони добре показували, наскільки крихке сучасне життя. Яким незручним воно стає, якщо енергосистему погашено обстрілами: це, мабуть, зачепило абсолютно кожного — холод, відсутність інтернету, ліфтів, подекуди — води. Але були і менші катастрофи, які ми помітили, і які було подолано за лічені дні.
Наприклад, всі ми пам’ятаємо, як 12 грудня 2023 року перестав працювати Київстар. Не можна було зателефонувати, скористатися мобільним інтернетом, а разом із мережею оператора тимчасово перестали працювати й деякі банкомати, POS-термінали та інші сервіси, що від неї залежали. Відновлення тривало кілька днів. Як мама, що відводить дитину в садок і постійно лишається на зв’язку на випадок, якщо вона захворіє або трапиться ще якась екстрена ситуація, я пам’ятаю, наскільки було некомфортно бігати містом без покриття.
А були ж ще катастрофи, які не сталися.
Наприклад, у квітні 2022 року російські хакери намагалися вимкнути українську енергосистему. Атаку вдалося зупинити буквально в останній момент. Більшість українців про це навіть не дізналася.
Сучасна IT-галузь бореться з аваріями до того, як вони стануться. І найкращий результат роботи, таким чином — це коли ми про роботу навіть не здогадуємося, бо системи так добре дубльовано, що ремонт проходить непоміченим.
Пов’язано це з тим, що інженери зазвичай планують не успіх, а невдачу. Виходить з ладу датацентр — сайт працює; відео не зупиняється, коли обривається кабель; файли не зникають із поламаним диском сервера.
Ця логіка стосується і звичайного сайту. Обираючи хостинг чи віртуальний сервер, варто зважати не лише на швидкість і обсяг пам’яті, а й на те, що буде з проєктом у разі аварії. Які резервні копії доступні, де вони зберігаються, хто і як відновлюватиме роботу — ці питання краще поставити ще до першого збою.
Для нас у Cityhost така підготовка — частина щоденної роботи. Компанія пройшла сертифікацію за ДСТУ ISO/IEC 27001 та ДСТУ ISO/IEC 27701, які стосуються управління інформаційною безпекою та захистом персональних даних. За цим стоять конкретні процедури: оцінка ризиків, визначення відповідальних осіб і порядок дій для реагування на інциденти та відновлення роботи.
Трохи історії катастроф
- Дорожчання помилки (1950-60 роки)
- Переломний момент: Tandem Computers
- RAID: дублювання жорстких дисків
- Катастрофа Y2K: найдорожчий апокаліпсис, який не стався
Хто тут молодший, не пригадує цього, але хто старший — має пам’ятати легенду про катастрофу нульового року — настане нове тисячоліття, таймери обнуляться, техніка збожеволіє, міста зануряться в апокаліпсис. Терпіння, зараз ми до цього повернемося, бо там є що розповісти, а поки…
Дорожчання помилки (1950-60 роки)
Перші комп’ютери просто ламалися і разом з тим зупинялася робота, яку на них виконували. Це не було зручно, проте нічого не вдієш: щось згоріло — чекаємо, доки полагодять. Проте розповсюдженість комп’ютерів була меншою, тож перерва в роботі була некомфортна, але не така критична, як зараз. Безперервну доступність будь-чого довгий час навіть не обговорювали: можна і потерпіти.
Безумовно, інженери працювали над тим, щоб поломки ставалися рідше. Але йшлося про те, щоб створити комп’ютер, який не ламається. Домінував саме цей напрямок.
Як завжди, все впиралося у фінанси.
Першими серйозно замислилися над безвідмовністю не розробники операційних систем, а люди, для яких кілька хвилин простою коштували величезних грошей.
Спочатку — авіакомпанії.
Уже в середині 1960-х системи бронювання квитків будували з кількох комп'ютерів, які могли підміняти один одного. Просто тому, що якщо система переставала продавати квитки, бізнес буквально зупинявся.
Потім підтягнулися банки. Пізніше — фондові біржі. Ще пізніше — телеком.
Наскільки я розумію, суть така: що більше сфер комп’ютеризували, таким чином пришвидшуючи і полегшуючи роботу, то більше коштувала й помилка. Ті, хто хотів працювати безперервно, просто ставили більше комп’ютерів.
Переломний момент: Tandem Computers
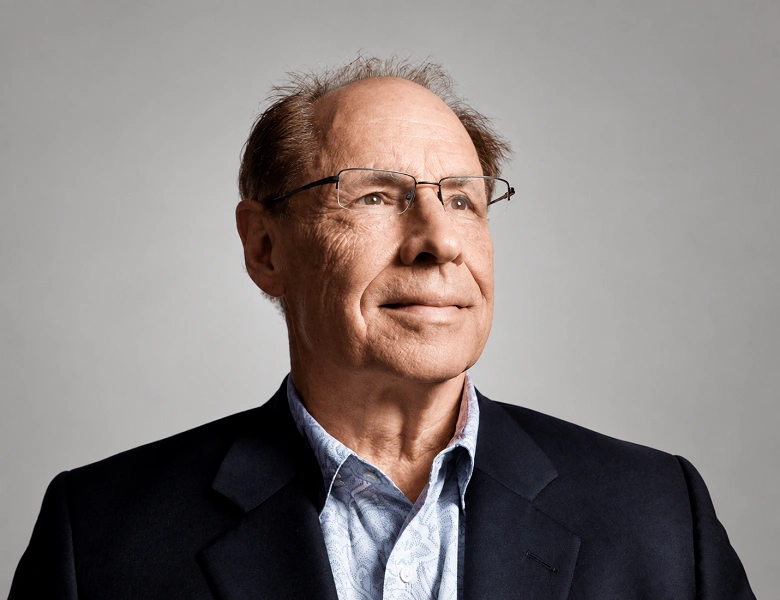
У 1974 році інженер HP Джеймс Трейбіг запропонував ідею: не намагатися зробити комп'ютер, який ніколи не ламається.
Замість цього — зробити комп'ютер, який може продовжувати працювати після поломки.
HP ця ідея не зацікавила.
Тоді він заснував власну компанію — Tandem Computers. Уже в 1976 році вона випустила систему NonStop, у якій майже не існувало єдиної точки відмови. Якщо процесор виходив із ладу, його миттєво підміняв інший. Якщо відмовляв диск — працювала його дзеркальна копія. Якщо ламався контролер — існував альтернативний шлях доступу до даних.
Джеймс Трейбіг
Перший такий комп’ютер відвантажили у Citibank у травні 1976 року. Далі ними обладнали фондові і товарні біржі — зокрема Чикагську товарну біржу, Лондонську фондову, NASDAQ тощо.
RAID: дублювання жорстких дисків
Наприкінці 1980-х стало очевидно: жорсткі диски — одна з найвразливіших частин комп'ютера. Вони виходили з ладу регулярно, а разом із ними могли зникнути всі дані.
Тому інженери поставили собі несподіване запитання.
А що, якщо перестати покладатися на один диск?
У 1988 році дослідники Каліфорнійського університету в Берклі опублікували роботу, яка популяризувала концепцію RAID (Redundant Array of Inexpensive Disks) — надлишкового масиву незалежних дисків. Суть її була в тому, щоби замість одного великого накопичувача використовувати кілька менших, які працюють разом.
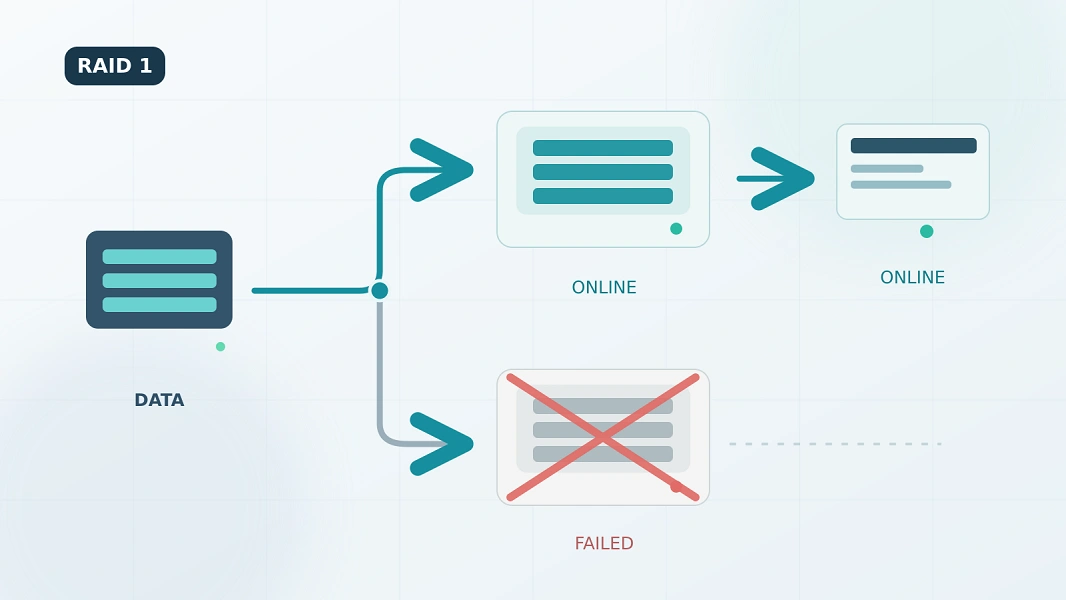
Залежно від конфігурації масив міг вирішувати різні завдання:
- RAID 1 записує однакові дані одразу на два диски. Якщо один виходить із ладу, другий продовжує працювати без втрати інформації.
- RAID 5 розподіляє дані та службову інформацію між трьома або більше дисками. Якщо один диск зламається, система може автоматично відновити втрачені дані після його заміни.
- RAID 10 поєднує дзеркалювання й розподіл даних, забезпечуючи і високу швидкість, і стійкість до відмов.
Не всі рівні RAID однаково захищають інформацію. Наприклад, RAID 0 взагалі створений для підвищення швидкості й не має резервування: вихід із ладу одного диска означає втрату всіх даних. Саме тому, коли говорять про захист від відмов, зазвичай мають на увазі RAID 1, RAID 5, RAID 6 або RAID 10.
І хоча сьогодні існують SSD, розподілені файлові системи та хмарні сховища, сама ідея RAID нікуди не зникла. Більшість серверів і NAS досі використовують її в тому чи іншому вигляді.
Але ось що тут для нас важливо. Весь час технічна думка рухалася від пошуку чогось безвідмовного до того, щоб зробити відмови не такими критичними. Ми приймаємо, що вони ставатимуться. Тож не потрібно створювати диск, який ніколи не зламається. Треба зробити так, щоб система після його поломки не зламалася теж.
Читайте також: Як дата-центри працюють «без світла» та в умовах постійних обстрілів енергетичної системи України
Катастрофа Y2K: найдорожчий апокаліпсис, який не стався
Давайте повернемося до катастрофи нульового року або Y2K. Це — якраз той випадок, коли біду відвернули так добре, що багато хто вирішив, ніби її не існувало. А між тим це — одна з найкраще задокументованих історій боротьби з катастрофою в IT.
Отже, в чому була суть занепокоєння: інженери в 1990-х зрозуміли, що мільйони програм використовують двозначний запис року. І це не було проблемою, доки тривало тисячоліття. Люди ж і самі так казали: «у вісімдесят першому я купив будинок». Але опівночі нового двотисячного року таймер мав обнулитися.
Абсолютно не факт, що всі літаки неодмінно впали б чи електромережі гарантовано зупинилися б. Проблема була в тому, що ніхто не знав, які саме системи відмовлять, і які наслідки це матиме.
Тоді по всьому світу інженери стали працювати так, наче катастрофа ось-ось станеться чи уже сталася.
«Завдання відремонтувати комп'ютерні системи до 2000 року спричинило безпрецедентну мобілізацію людей, грошей та управлінської уваги, якій майже немає аналогів в історії», — пише «Вашингтон Пост» у 1998 році.
До речі, цей же кореспондент називає і суми, витрачені на цю роботу. Федеральний резерв, каже журналіст Раджив Чандрасекаран, передбачає, що бізнеси витратять на це принаймні 50 мільярдів доларів лише в США. Там є і більш гігантські цифри. Прогнози витрат на подолання проблеми 2000 року різнилися, а фінальну цифру досі теж ніхто не підрахував. Проте вона перевищує 300 мільярдів на увесь світ, причому десь половина цієї суми прийшлася на США.
Це був масштабний аудит всього програмного забезпечення. Компанії йшли різними шляхами:
- знаходили всі місця, де в коді важлива була дата. Інженери переглядали мільйони рядків коду в пошуках місць, де рік записувався двома цифрами. Часто це був COBOL-код, написаний ще у 1960–1970-х роках. Документації нерідко вже не існувало, а автори давно звільнилися або вийшли на пенсію. Саме тому багатьох пенсіонерів-програмістів тимчасово повернули до роботи.
- міняли програми і використання дати в банкоматах, медичному обладнанні, пристроях для електромереж, авіаційних систем тощо. Якщо зміна запису дати була неможлива, техніку замінювали;
- робили резервні копії всього, що мали;
- робили стрес-тести, переводячи дату в системі на нульовий рік штучно, і дивилися, що виходить з ладу.
Нарешті, вночі на Новий нульовий рік багато хто не святкував, а чергував на роботі.
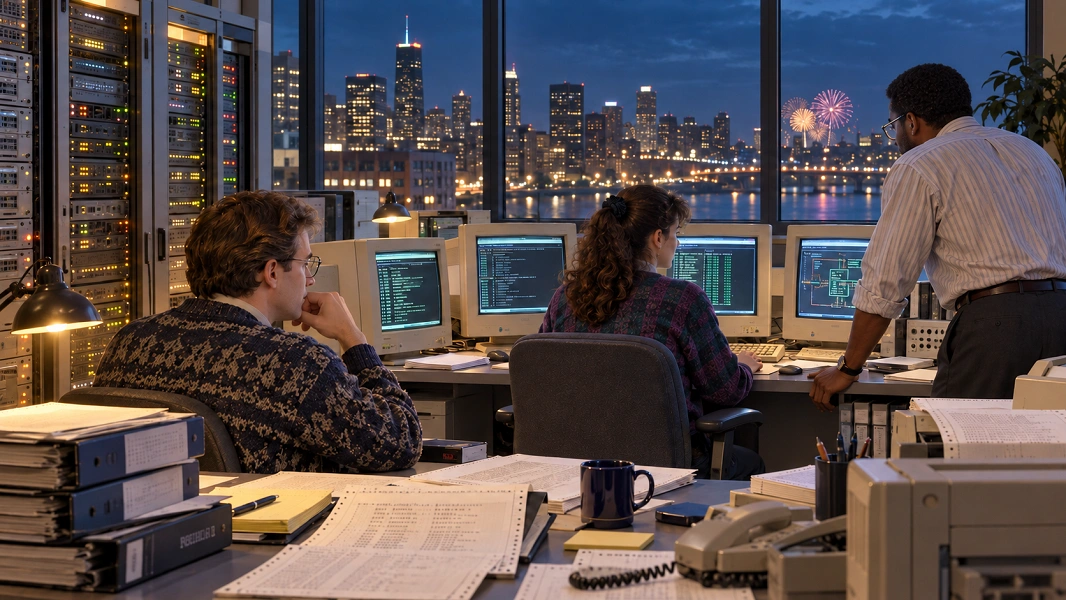
І коли 1 січня 2000 року серйозної катастрофи не сталося, багато хто вирішив, що небезпека була вигаданою.
Але насправді це була одна з найуспішніших операцій із запобігання техногенній катастрофі в історії людства.
Людство витратило суму, співставну з річним ВВП великої держави, не на створення чогось нового, а на те, щоб 1 січня 2000 року все продовжило працювати як учора.
Y2K не була останньою «проблемою дат». Подібні збої повторювалися і в 2022 році (нам було, щоправда, не до того), коли через переповнення числового формату виникли проблеми в Microsoft Exchange та деяких GPS-навігаторах. Це було пов’язано з тим, деякі програми записували дату у форматі YYMMDDHHMM і зберігали її як 32-бітне ціле число.
Наступний відомий рубіж — 2038 рік, і індустрія вже давно готується до нього. Докладніше про наступні збої, пов’язані з датами, можна почитати не далі, ніж у Вікіпедії.
Проте ця історія стала величезним поштовхом вперед: подивіться, тут використовувалося все те, що ми знаємо з нашого життя — і резервні копії, і тестування системи на стійкість перед тією чи іншою подією.
У будь-якому разі головний висновок, який зрештою зробили всі: питання не в тому, чи щось зламається, питання в тому, коли. І в тому, як ти до цього підготуєшся.
Три головні принципи сучасної інфраструктури
Поступово стало ясно, що різні катастрофи потребують різних реакцій. Так сформувалися три принципи захисту сучасної інфраструктури.
Backup — якщо дані втрачено
Причиною може бути що завгодно: поломка диска, помилка адміністратора, вірус-шифрувальник, пожежа чи фізичне знищення датацентру.
Саме тому сучасний backup — це не копія на сусідньому диску. Найкращою практикою вважається правило 3-2-1: три копії даних, два різні носії та щонайменше одна копія — в іншому місці. Війна з росією лише підтвердила важливість цього підходу: для багатьох компаній резервна копія в іншій країні стала просто необхідністю.
Redundancy — якщо щось зламається
Як зробити так, щоб система не перестала працювати через поломку одного компонента?
Сучасні сервіси дублюють усе критично важливе: сервери, диски, мережеві маршрути, джерела живлення і навіть цілі датацентри. Ідея проста: якщо один елемент виходить із ладу, є інший, який може взяти на себе його роботу.
Failover — якщо аварія вже сталася
Але запасний сервер сам по собі нічого не вирішує. Як перейти на нього настільки швидко, щоб користувач цього навіть не помітив?
Для цього потрібно автоматично перемкнутися на резервну систему, перевірити, що вона працює правильно, і продовжити роботу без тривалої перерви. Таке перемикання називається failover. Завдяки йому навіть після виходу з ладу цілого датацентру можуть продовжувати працювати хмарні сервіси, банки, стримінги тощо.
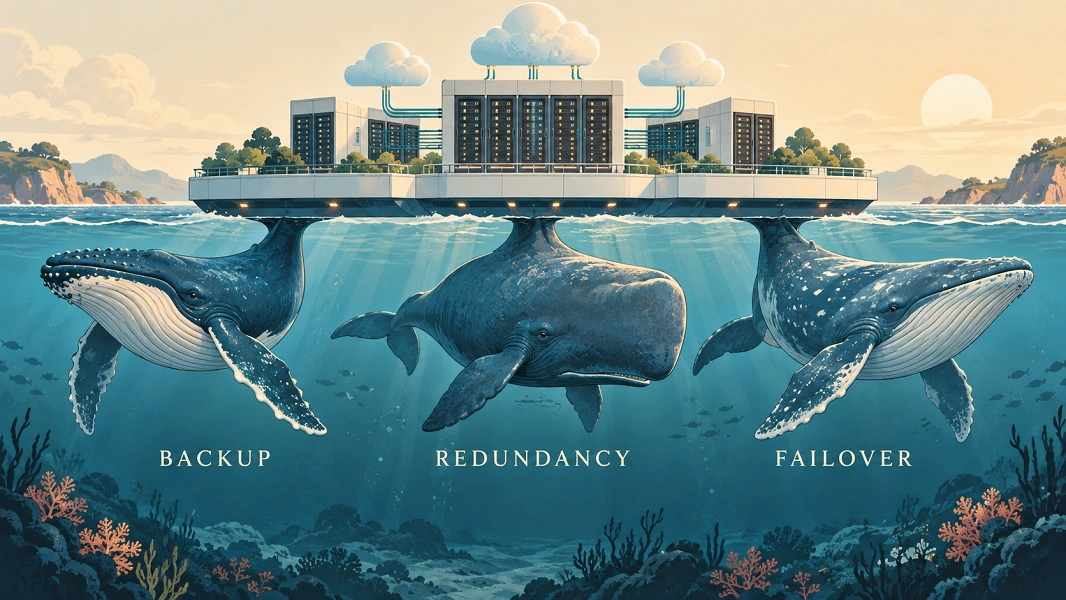
Ці три принципи не замінюють один одного.
- Backup повертає втрачені дані.
- Redundancy не дає системі впасти через одну поломку.
- Failover забезпечує плавний перехід на резервні ресурси.
Саме тому сучасне ІТ дедалі менше покладається на надійність окремих комп'ютерів і дедалі більше — на архітектуру всієї системи. Інженери більше не намагаються побудувати сервер, який ніколи не зламається. Вони будують інфраструктуру, для якої поломка — це не виняток, а сценарій, передбачений ще на етапі проєктування.
Читайте також: 31 березня — день резервного копіювання. Чому важливо не забувати про бекапи та як зробити резервну копію свого сайту (інструкція)
Історії (не) успіху
Навіть великі технологічні компанії, у яких є гроші, досвідчені інженери й сучасне обладнання, не застраховані від серйозних збоїв. На щастя, деякі з них відкрито розповідають про свої помилки та способи їх виправлення. Завдяки цьому вчитися на таких аваріях може вся галузь.
Як GitLab мало не втратили все (2017)
У 2017 році адміністратор GitLab випадково видалив робочу базу даних.
Здавалося, нічого страшного — є ж резервні копії. Виявилося, що одна копія давно не оновлювалася, інша була пошкоджена, третя взагалі не запускалася; реплікація теж працювала неправильно.
Зрештою врятувала ситуацію зовсім інша технологія — snapshot, тобто миттєвий знімок файлової системи, який зберігався на тестовому сервері. Він був зроблений приблизно за шість годин до аварії. Саме з нього понад 18 годин відновлювали роботу сервісу.
Шість годин змін у базі даних було втрачено безповоротно, але сама база повернулась до роботи.
«Ми також стрімили процедуру відновлення на YouTube, на піку трансляції на ній сиділо близько 5 тисяч глядачів», пишуть в компанії (повний опис ситуації і дій з відновлення можна знайти отут).
Ця історія добре показує, чому резервне копіювання в сучасному ІТ сприймають як процес, а не як файл. Недостатньо одного разу створити backup — потрібно регулярно перевіряти, що його можна запустити, і що він актуальний.
AWS і народження Chaos Monkey
У 2008 році Netflix пережив дуже болючий збій власної Oracle-бази даних. Через це компанія три дні не могла відправляти DVD клієнтам. Саме тоді керівництво вирішило: потрібно відмовлятися від єдиної великої бази й переходити на хмарну, розподілену архітектуру. Наслідком став переїзд на AWS (Amazon Web Services), величезну хмарну платформу, що дозволяє запускати сервіси на серверах Amazon.
Проте цей переїзд створив певну проблему. Там, де в системі тисячі серверів, сама хмара застрахована від падіння — інші сервери підхоплюють навантаження того, що зламався. Проте чи цього досить, щоб робота конкретно вашого сервіса була безперебійна? Адже хмара не знає, як побудована саме ваша робота — ця відповідальність лежить на спеціалістах Netflix. Якщо архітектура сервісу залежить від одного критичного компонента, аварія все одно призведе до збою.
Щоб відповісти на це питання, Netflix у 2010 році створили програму Chaos Monkey, яка в рамках тестування випадково вимикає окремі сервери, що працюють саме на конкретну компанію. Якщо після вимкнення одного чи кількох серверів щось зламалося чи впало — функції дубльовані недостатньо.
У 2012 році компанія відкрила код цієї програми, і багато інших бізнесів почали впроваджувати у себе щось схоже, переписане під себе.
Chaos Monkey не став програмою, яку встановили всі. Натомість він популяризував саму ідею chaos engineering. Сьогодні великі компанії регулярно моделюють аварії, але часто використовують уже власні інструменти або нові платформи для тестування відмов.
Якщо зробити крок назад, то Chaos Monkey лише автоматизував те, що під час підготовки до Y2K інженери робили вручну: створювали контрольовані аварії, щоб перевірити, чи система переживе справжню.
Ми бачимо, що жоден із цих підходів не виник раптово, всі формувалися тривалий час із практики. Реальність недосконала, і тому доводиться постійно страхувати і дублювати все важливе, тому що проблеми у нас будуть неодмінно. Мені здається, ця філософія ідеально гармоніює з нашим геть не ідеальним життям під час війни.