Мы все можем вспомнить несколько масштабных сбоев, которые нас коснулись. Они хорошо показывали, насколько хрупка современная жизнь. Какой неудобной она становится, если энергосистема отключена обстрелами: это, наверное, затронуло абсолютно каждого — холод, отсутствие интернета, лифтов, местами — воды. Но были и меньшие катастрофы, которые мы заметили, и которые были преодолены за считанные дни.
Например, все мы помним, как 12 декабря 2023 года перестал работать Киевстар. Нельзя было позвонить, воспользоваться мобильным интернетом, а вместе с сетью оператора временно перестали работать и некоторые банкоматы, POS-терминалы и другие сервисы, которые от нее зависели. Восстановление длилось несколько дней. Как мама, которая отвозит ребенка в садик и постоянно остается на связи на случай, если она заболеет или произойдет какая-то экстренная ситуация, я помню, насколько было некомфортно бегать по городу без покрытия.
А были же еще катастрофы, которые не произошли.
Например, в апреле 2022 года российские хакеры пытались отключить украинскую энергосистему. Атаку удалось остановить буквально в последний момент. Большинство украинцев об этом даже не узнали.
Современная IT-отрасль борется с авариями до того, как они произойдут. И лучший результат работы, таким образом — это когда мы о работе даже не догадываемся, потому что системы так хорошо дублированы, что ремонт проходит незамеченным.
Связано это с тем, что инженеры обычно планируют не успех, а неудачу. Выходит из строя датацентр — сайт работает; видео не останавливается, когда обрывается кабель; файлы не исчезают с поломанным диском сервера.
Эта логика касается и обычного сайта. Выбирая хостинг или виртуальный сервер, стоит учитывать не только скорость и объем памяти, а и то, что будет с проектом в случае аварии. Какие резервные копии доступны, где они хранятся, кто и как будет восстанавливать работу — эти вопросы лучше задать еще до первого сбоя.
Для нас в Cityhost такая подготовка — часть повседневной работы. Компания прошла сертификацию по ДСТУ ISO/IEC 27001 и ДСТУ ISO/IEC 27701, которые касаются управления информационной безопасностью и защиты персональных данных. За этим стоят конкретные процедуры: оценка рисков, определение ответственных лиц и порядок действий для реагирования на инциденты и восстановления работы.
Немного истории катастроф
- Подорожание ошибки (1950-60 годы)
- Переломный момент: Tandem Computers
- RAID: дублирование жестких дисков
- Катастрофа Y2K: самый дорогой апокалипсис, который не произошел
Кто здесь младше, не помнит этого, но кто старше — должен помнить легенду о катастрофе нулевого года — наступит новое тысячелетие, таймеры обнулятся, техника сойдет с ума, города погрузятся в апокалипсис. Терпение, сейчас мы к этому вернемся, потому что там есть что рассказать, а пока…
Подорожание ошибки (1950-60 годы)
Первые компьютеры просто ломались и вместе с тем останавливалась работа, которую на них выполняли. Это не было удобно, однако ничего не поделаешь: что-то сгорело — ждем, пока починят. Однако распространенность компьютеров была меньшей, так что перерыв в работе был неудобным, но не таким критичным, как сейчас. Непрерывную доступность чего-либо долгое время даже не обсуждали: можно и потерпеть.
Безусловно, инженеры работали над тем, чтобы поломки происходили реже. Но речь шла о том, чтобы создать компьютер, который не ломается. Доминировал именно этот направление.
Как всегда, все упиралось в финансы.
Первыми серьезно задумались о безотказности не разработчики операционных систем, а люди, для которых несколько минут простоя стоили огромных денег.
Сначала — авиакомпании.
Уже в середине 1960-х системы бронирования билетов строились из нескольких компьютеров, которые могли подменять друг друга. Просто потому, что если система переставала продавать билеты, бизнес буквально останавливался.
Потом подтянулись банки. Позже — фондовые биржи. Еще позже — телеком.
Насколько я понимаю, суть такова: чем больше сфер компьютеризировали, таким образом ускоряя и облегчая работу, тем больше стоила и ошибка. Те, кто хотел работать непрерывно, просто ставили больше компьютеров.
Переломный момент: Tandem Computers
В 1974 году инженер HP Джеймс Трейбиг предложил идею: не пытаться сделать компьютер, который никогда не ломается.
Вместо этого — сделать компьютер, который может продолжать работать после поломки.
HP эта идея не заинтересовала.
Тогда он основал собственную компанию — Tandem Computers. Уже в 1976 году она выпустила систему NonStop, в которой почти не существовало единой точки отказа. Если процессор выходил из строя, его мгновенно подменял другой. Если отказывал диск — работала его зеркальная копия. Если ломался контроллер — существовал альтернативный путь доступа к данным.
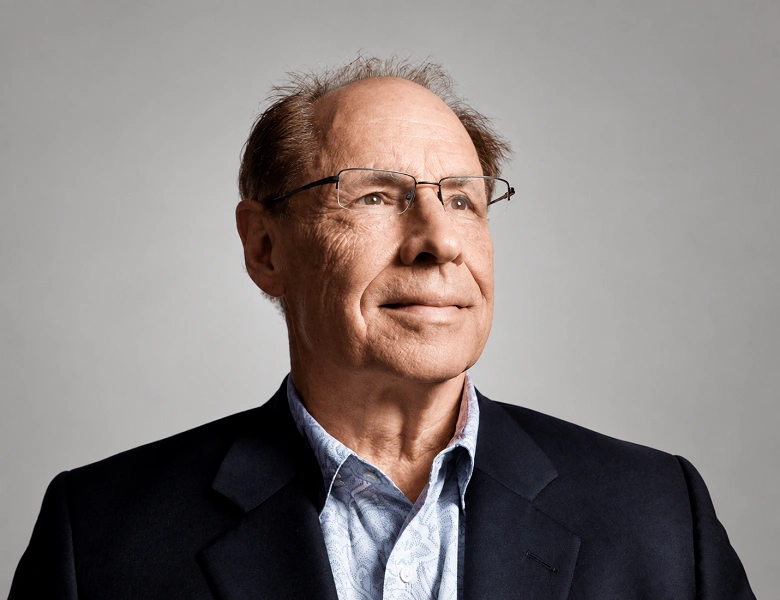
Джеймс Трейбиг
Первый такой компьютер отгрузили в Citibank в мае 1976 года. Далее ими оснастили фондовые и товарные биржи — в частности Чикагскую товарную биржу, Лондонскую фондовую, NASDAQ и т.д.
RAID: дублирование жестких дисков
В конце 1980-х стало очевидно: жесткие диски — одна из самых уязвимых частей компьютера. Они выходили из строя регулярно, а вместе с ними могли исчезнуть все данные.
Поэтому инженеры поставили себе неожиданный вопрос.
А что, если перестать полагаться на один диск?
В 1988 году исследователи Калифорнийского университета в Беркли опубликовали работу, которая популяризировала концепцию RAID (Redundant Array of Inexpensive Disks) — избыточного массива независимых дисков. Суть ее была в том, чтобы вместо одного большого накопителя использовать несколько меньших, которые работают вместе.
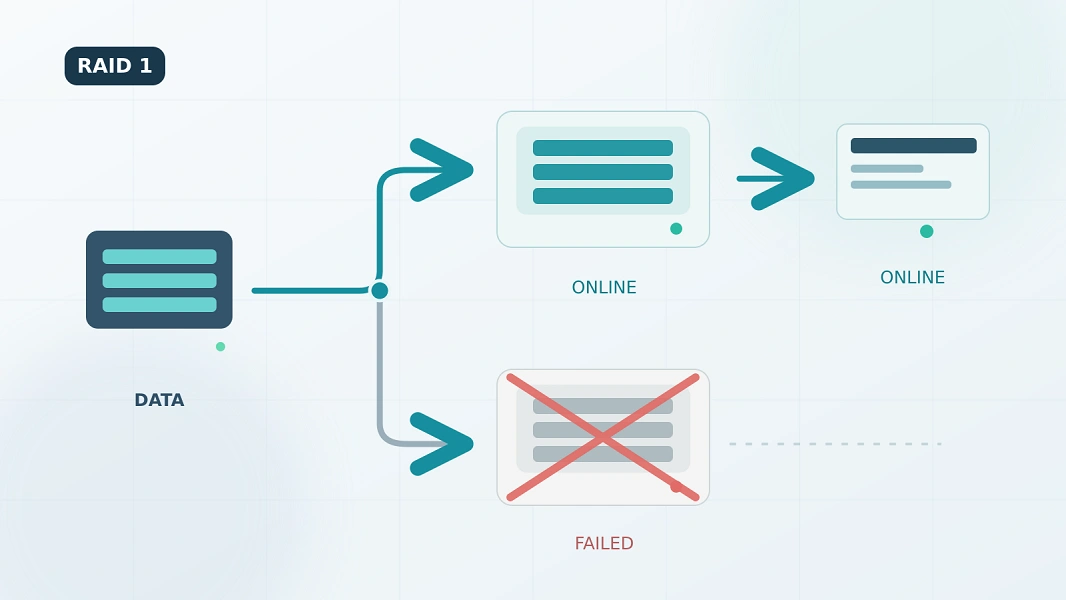
В зависимости от конфигурации массив мог решать различные задачи:
- RAID 1 записывает одинаковые данные сразу на два диска. Если один выходит из строя, второй продолжает работать без потери информации.
- RAID 5 распределяет данные и служебную информацию между тремя или более дисками. Если один диск сломается, система может автоматически восстановить потерянные данные после его замены.
- RAID 10 сочетает зеркалирование и распределение данных, обеспечивая и высокую скорость, и устойчивость к отказам.
Не все уровни RAID одинаково защищают информацию. Например, RAID 0 вообще создан для повышения скорости и не имеет резервирования: выход из строя одного диска означает потерю всех данных. Именно поэтому, когда говорят о защите от отказов, обычно имеют в виду RAID 1, RAID 5, RAID 6 или RAID 10.
И хотя сегодня существуют SSD, распределенные файловые системы и облачные хранилища, сама идея RAID никуда не исчезла. Большинство серверов и NAS до сих пор используют ее в том или ином виде.
Но вот что здесь для нас важно. Все время техническая мысль двигалась от поиска чего-то безотказного к тому, чтобы сделать отказы не такими критичными. Мы принимаем, что они будут происходить. Так что не нужно создавать диск, который никогда не сломается. Нужно сделать так, чтобы система после его поломки не сломалась тоже.
Читайте также: Как дата-центры работают «без света» и в условиях постоянных обстрелов энергетической системы Украины
Катастрофа Y2K: самый дорогой апокалипсис, который не произошел
Давайте вернемся к катастрофе нулевого года или Y2K. Это — как раз тот случай, когда беду отразили так хорошо, что многие решили, будто ее не существовало. А между тем это — одна из лучших задокументированных историй борьбы с катастрофой в IT.
Итак, в чем была суть беспокойства: инженеры в 1990-х поняли, что миллионы программ используют двузначную запись года. И это не было проблемой, пока продолжалось тысячелетие. Люди же сами так говорили: «в восемьдесят первом я купил дом». Но в полночь нового двухтысячного года таймер должен был обнулиться.
Абсолютно не факт, что все самолеты непременно упали бы или электросети гарантированно остановились бы. Проблема была в том, что никто не знал, какие именно системы откажут, и какие последствия это будет иметь.
Тогда по всему миру инженеры стали работать так, словно катастрофа вот-вот произойдет или уже произошла.
«Задача отремонтировать компьютерные системы до 2000 года вызвала беспрецедентную мобилизацию людей, денег и управленческого внимания, которой почти нет аналогов в истории», — пишет «Вашингтон Пост» в 1998 году.
Кстати, этот же корреспондент называет и суммы, потраченные на эту работу. Федеральный резерв, говорит журналист Раджив Чандрасекаран, предполагает, что бизнесы потратят на это как минимум 50 миллиардов долларов только в США. Там есть и более гигантские цифры. Прогнозы затрат на преодоление проблемы 2000 года различались, а финальную цифру до сих пор тоже никто не подсчитал. Однако она превышает 300 миллиардов на весь мир, причем где-то половина этой суммы пришлась на США.
Это был масштабный аудит всего программного обеспечения. Компании шли разными путями:
- находили все места, где в коде важна была дата. Инженеры просматривали миллионы строк кода в поисках мест, где год записывался двумя цифрами. Часто это был COBOL-код, написанный еще в 1960–1970-х годах. Документации нередко уже не существовало, а авторы давно уволились или вышли на пенсию. Именно поэтому многих пенсионеров-программистов временно вернули к работе.
- меняли программы и использование даты в банкоматах, медицинском оборудовании, устройствах для электросетей, авиационных системах и т.д. Если изменение записи даты было невозможно, технику заменяли;
- делали резервные копии всего, что имели;
- делали стресс-тесты, переводя дату в системе на нулевой год искусственно, и смотрели, что выходит из строя.
Наконец, в ночь на Новый нулевой год многие не праздновали, а дежурили на работе.
И когда 1 января 2000 года серьезной катастрофы не произошло, многие решили, что опасность была вымышленной.
Но на самом деле это была одна из самых успешных операций по предотвращению техногенной катастрофы в истории человечества.
Человечество потратило сумму, сопоставимую с годовым ВВП большой державы, не на создание чего-то нового, а на то, чтобы 1 января 2000 года все продолжало работать как вчера.
Y2K не была последней «проблемой дат». Подобные сбои повторялись и в 2022 году (нам было, правда, не до того), когда из-за переполнения числового формата возникли проблемы в Microsoft Exchange и некоторых GPS-навигаторах. Это было связано с тем, что некоторые программы записывали дату в формате YYMMDDHHMM и хранили ее как 32-битное целое число.
Следующий известный рубеж — 2038 год, и индустрия уже давно готовится к нему. Подробно о следующих сбоях, связанных с датами, можно прочитать не далее, чем в Википедии.
Тем не менее эта история стала огромным толчком вперед: посмотрите, здесь использовалось все то, что мы знаем из нашей жизни — и резервные копии, и тестирование системы на устойчивость перед той или иной ситуацией.
В любом случае главный вывод, который в итоге сделали все: вопрос не в том, сломается ли что-то, вопрос в том, когда. И в том, как ты к этому подготовишься.
Три главных принципа современной инфраструктуры
- Backup — если данные потеряны
- Redundancy — если что-то сломается
- Failover — если авария уже произошла
Постепенно стало ясно, что различные катастрофы требуют различных реакций. Так сформировались три принципа защиты современной инфраструктуры.
Backup — если данные потеряны
Причиной может быть что угодно: поломка диска, ошибка администратора, вирус-шифровальщик, пожар или физическое уничтожение датацентра.
Именно поэтому современный backup — это не копия на соседнем диске. Лучшей практикой считается правило 3-2-1: три копии данных, два различных носителя и как минимум одна копия — в другом месте. Война с россией лишь подтвердила важность этого подхода: для многих компаний резервная копия в другой стране стала просто необходимостью.
Redundancy — если что-то сломается
Как сделать так, чтобы система не перестала работать из-за поломки одного компонента?
Современные сервисы дублируют все критически важное: серверы, диски, сетевые маршруты, источники питания и даже целые датацентры. Идея проста: если один элемент выходит из строя, есть другой, который может взять на себя его работу.
Failover — если авария уже произошла
Но запасной сервер сам по себе ничего не решает. Как перейти на него настолько быстро, чтобы пользователь этого даже не заметил?
Для этого нужно автоматически переключиться на резервную систему, проверить, что она работает правильно, и продолжить работу без длительной паузы. Такое переключение называется failover. Благодаря ему даже после выхода из строя целого датацентра могут продолжать работать облачные сервисы, банки, стриминги и т.д.
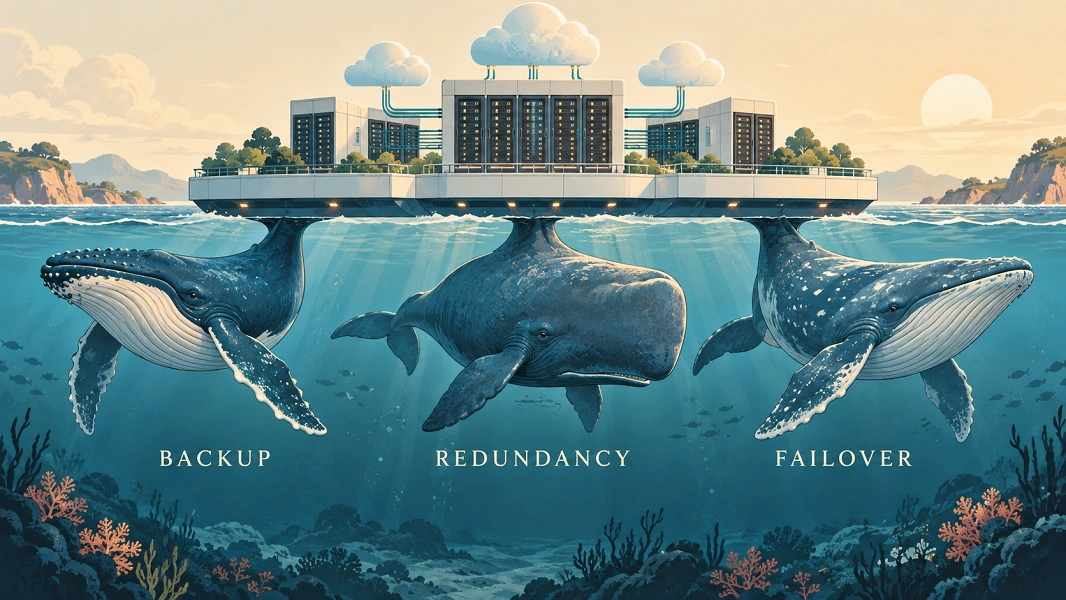
Эти три принципа не заменяют друг друга.
- Backup возвращает потерянные данные.
- Redundancy не дает системе упасть из-за одной поломки.
- Failover обеспечивает плавный переход на резервные ресурсы.
Именно поэтому современное ИТ все меньше полагается на надежность отдельных компьютеров и все больше — на архитектуру всей системы. Инженеры больше не пытаются построить сервер, который никогда не сломается. Они строят инфраструктуру, для которой поломка — это не исключение, а сценарий, предусмотренный еще на этапе проектирования.
Читайте также: 31 марта — день резервного копирования. Почему важно не забывать о бэкапе и как сделать резервную копию своего сайта (инструкция)
Истории (не) успеха
Даже большие технологические компании, у которых есть деньги, опытные инженеры и современное оборудование, не застрахованы от серьезных сбоев. К счастью, некоторые из них открыто рассказывают о своих ошибках и способах их исправления. Благодаря этому учиться на таких авариях может вся отрасль.
Как GitLab чуть не потеряли все (2017)
В 2017 году администратор GitLab случайно удалил рабочую базу данных.
Казалось, ничего страшного — есть же резервные копии. Оказалось, что одна копия давно не обновлялась, другая была повреждена, третья вообще не запускалась; репликация тоже работала неправильно.
В конечном итоге спасла ситуацию совсем другая технология — snapshot, то есть моментальный снимок файловой системы, который хранился на тестовом сервере. Он был сделан примерно за шесть часов до аварии. Именно с него более 18 часов восстанавливали работу сервиса.
Шесть часов изменений в базе данных были утеряны безвозвратно, но сама база вернулась к работе.
«Мы также стримили процедуру восстановления на YouTube, на пике трансляции на ней сидело около 5 тысяч зрителей», пишут в компании (полное описание ситуации и действий по восстановлению можно найти здесь).
Эта история хорошо показывает, почему резервное копирование в современном ИТ воспринимают как процесс, а не как файл. Недостаточно один раз создать backup — нужно регулярно проверять, что его можно запустить, и что он актуален.
AWS и рождение Chaos Monkey
В 2008 году Netflix пережил очень болезненный сбой собственной Oracle-базы данных. Из-за этого компания три дня не могла отправлять DVD клиентам. Именно тогда руководство решило: нужно отказываться от единой большой базы и переходить на облачную, распределенную архитектуру. Следствием стал переезд на AWS (Amazon Web Services), огромную облачную платформу, которая позволяет запускать сервисы на серверах Amazon.
Однако этот переезд создал определенную проблему. Там, где в системе тысячи серверов, само облако застраховано от падения — другие серверы подхватывают нагрузку того, что сломался. Однако достаточно ли этого, чтобы работа конкретно вашего сервиса была бесперебойной? Ведь облако не знает, как построена именно ваша работа — эта ответственность лежит на специалистах Netflix. Если архитектура сервиса зависит от одного критического компонента, авария все равно приведет к сбою.
Чтобы ответить на этот вопрос, Netflix в 2010 году создали программу Chaos Monkey, которая в рамках тестирования случайно выключает отдельные серверы, работающие именно на конкретную компанию. Если после выключения одного или нескольких серверов что-то сломалось или упало — функции дублированы недостаточно.
В 2012 году компания открыла код этой программы, и многие другие бизнесы начали внедрять у себя что-то похожее, переписанное под себя.
Chaos Monkey не стал программой, которую установили все. Напротив, он популяризировал саму идею chaos engineering. Сегодня большие компании регулярно моделируют аварии, но часто используют уже собственные инструменты или новые платформы для тестирования отказов.
Если сделать шаг назад, то Chaos Monkey лишь автоматизировал то, что во время подготовки к Y2K инженеры делали вручную: создавали контролируемые аварии, чтобы проверить, выдержит ли система настоящую.
Мы видим, что ни один из этих подходов не возник внезапно, все формировались длительное время из практики. Реальность несовершенна, и поэтому приходится постоянно страховать и дублировать все важное, потому что проблемы у нас будут непременно. Мне кажется, эта философия идеально гармонирует с нашей далеко не идеальной жизнью во время войны.