
- Was ist AI-Scraping
- Welche Folgen hat AI-Scraping für die Website
- Wie man AI-Scraping auf der Website überprüft
- Wie man die Last durch AI-Scraping verringert
- Ist es möglich, schädliches AI-Scraping vollständig zu stoppen
Sie überwachen ein Internetprojekt: optimieren Datenbanken, komprimieren Bilder, entfernen überflüssigen Code. Die Anzahl der Besucher steigt, aber plötzlich bemerken Sie, dass der Server anfängt, Fehler auszugeben, oder Sie erhalten eine E-Mail vom Anbieter über Überschreitung der Limits. Obwohl man sich sofort selbst für unzureichende Optimierung beschuldigen möchte, kann der Grund in unzureichendem Schutz der Website vor AI-Scraping liegen. Während Sie maximale Anstrengungen in die Erstellung von Inhalten und technische Verbesserungen stecken, stiehlt jemand in Sekundenschnelle Ihre Materialien und führt zu abnormalen Lasten. Ich habe dies auf meinem eigenen Web-Ressource überprüft und werde zeigen, wie man solche Bots findet und ihre Aktivitäten ohne Schaden für SEO und GEO einschränkt.
Was ist AI-Scraping
AI-Scraping ist die automatische Sammlung von Inhalten von Websites durch Systeme der künstlichen Intelligenz. Dies können sowohl große KI-Unternehmen wie OpenAI und Anthropic sein, die Modelle trainieren, Antworten in der Suche formulieren und Seiten auf Anfrage des Nutzers öffnen, als auch anonyme Scraper, die sich als gewöhnlicher Browser tarnen.
AI-Scraping sollte nicht mit klassischem Website-Parsen verwechselt werden, das spezifische Daten wie die Preise von Wettbewerbern sammelt. Stattdessen durchforsten Bots der künstlichen Intelligenz die gesamte Web-Ressource, einschließlich alter Artikel und Archive, wodurch sie den Server anders belasten als lebende Besucher.
Welche Folgen hat AI-Scraping für die Website
Die Hauptfolgen von AI-Scraping für die Website sind: Überlastung des Hostings, Inhalte ohne Rückverkehre und Kopien Ihrer Materialien auf fremden Ressourcen.
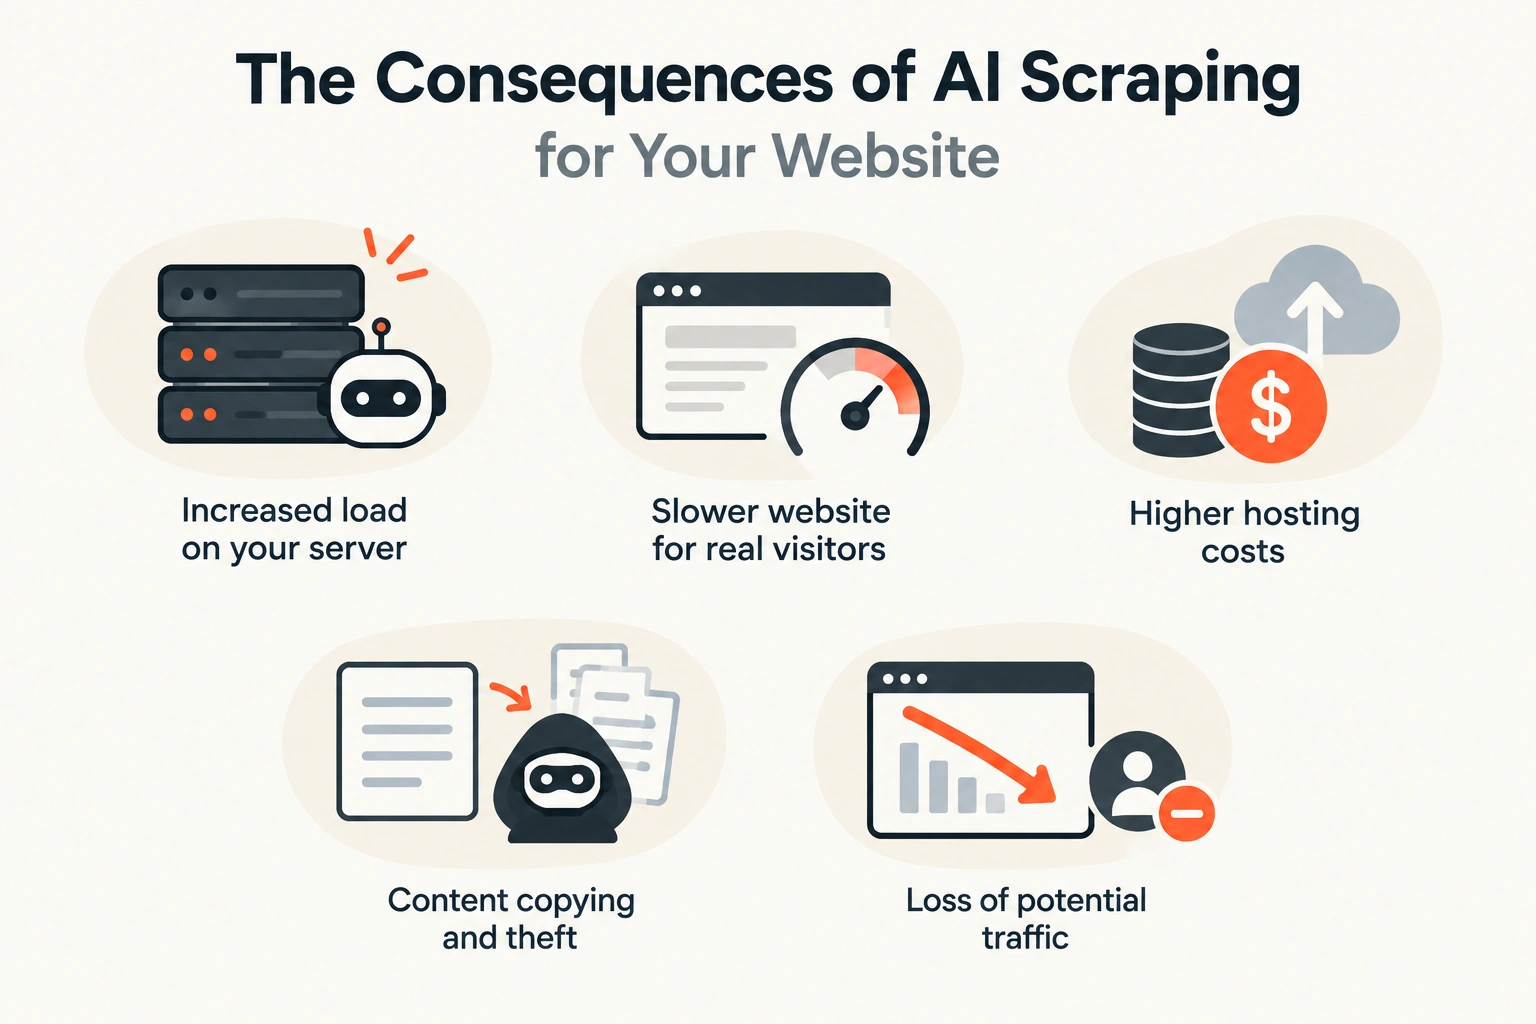
Jede Folge ist für Internetprojekte jeder Größe von Bedeutung:
- Belastung des Hostings. Eine Person öffnet mehrere Seiten und liest jede einige Minuten, während ein Bot innerhalb einer Stunde Tausende von Adressen durchsehen kann, einschließlich alter und technischer, die nicht im Cache sind. Der Server startet jedes Mal PHP und greift auf die Datenbank zu, sodass die Website für lebende Besucher langsamer wird oder überhaupt nicht mehr geöffnet werden kann.
- Inhalte ohne Rückverkehr. AI-Systeme entnehmen Texte viel häufiger, als sie Leser bringen. Laut TollBit erhalten europäische Verleger etwa 179 Besuche von AI-Bots pro einem Besuch eines lebenden Nutzers.
- Kopieren von Inhalten. Die Publikation The Media Copilot berichtet über einen TollBit-Bericht, der fast 40 Dienste beschreibt, die Scraping-Dienste verkaufen: Viele von ihnen ignorieren standardmäßig robots.txt, und einige umgehen sogar den kostenpflichtigen Zugang. Infolgedessen landet Ihr Inhalt auf fremden Web-Ressourcen und kann dort sogar besser eingestuft werden.
Sie könnten denken, dass Ihrer kleinen Website nichts droht, aber Bots suchen nicht gezielt nach bestimmten Web-Ressourcen, sondern verarbeiten Adresslisten. Suchbots finden Seiten über Links und Sitemaps. Common Crawl durchforstet jeden Monat über 2 Milliarden Seiten für offene Archive, auf denen Sprachmodelle trainiert werden. Und Scraper nutzen öffentliche SSL-Zertifikatsprotokolle, um innerhalb weniger Minuten eine neue Domain zu finden.
Ende Juli 2026 beschrieb der Eigentümer eines kleinen Wikis auf Medium, wie der Bot meta-webindexer innerhalb von anderthalb Tagen 230.743 Anfragen an eine Website mit 4.814 Artikeln stellte. Alte Versionen und Bearbeitungsseiten verwandelten mehrere tausend Artikel in Hunderttausende von Adressen, 98% der Anfragen gingen an in robots.txt verbotene Seiten, und der Bot nahm 47% des Ausgangsverkehrs weg, wodurch die Rechnung für den Cloud-Server sich etwa verdoppelte.
Wie man AI-Scraping auf der Website überprüft
Um AI-Scraping zu überprüfen, vergleichen Sie drei Quellen: die Lastgrafik im Hosting-Panel, die Anzahl der lebenden Besucher in Google Analytics und das Protokoll der Anfragen an die Website. Über AI-Scraping kann man nur sprechen, wenn die Lastspitzen zeitlich mit den Serien von Anfragen bestimmter AI-Bots übereinstimmen.
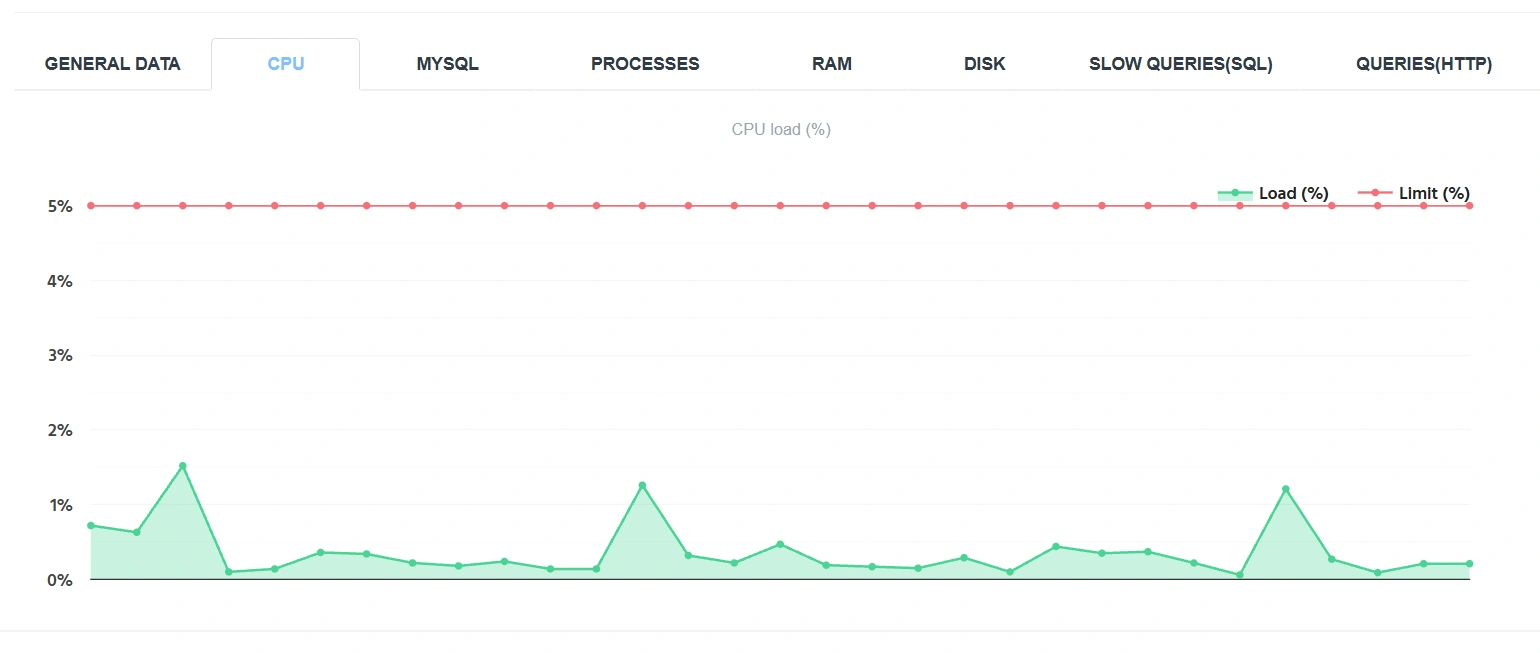
Auf dem Screenshot ist die Lastgrafik des Hostings eines der Projekte auf Cityhost (veröffentlicht mit Zustimmung des Eigentümers).
Finden Sie zunächst die Lastspitzen:
- Öffnen Sie das Cityhost-Panel → Hosting 2.0 → Verwaltung → Ressourcen.
- Gehen Sie zur CPU-Registerkarte und wählen Sie den längsten verfügbaren Zeitraum aus.
- Notieren Sie das Datum und die Uhrzeit jedes Moments, in dem die Grafik das Limit erreicht hat.
Auf meiner Website erreichte der Prozessor innerhalb einer Woche mehrmals das Limit von 100%, obwohl die durchschnittliche Last 40% betrug. Vergleichen Sie danach diese Lasten mit der Anzahl der realen Besucher auf Ihrem Web-Ressource im gleichen Zeitraum:

- Öffnen Sie Google Analytics 4 → Erkunden → Freiform.
- Stellen Sie den Zeitraum ein, der Ihre Spitzen umfasst.
- Fügen Sie den Parameter «Datum und Uhrzeit (YYYYMMDDHH)» in «Zeilen» ein, und die Kennzahl «Sitzungen» in «Werte».
- Suchen Sie in der Tabelle nach den Stunden Ihrer Spitzen.
GA4 schließt automatisch bekannte Bots aus, und die meisten anderen führen kein JavaScript aus, sodass der Zähler nur Menschen sieht. Wenn die Last gestiegen ist, aber die Sitzungen nicht zugenommen haben, liegt der Grund bei Bots oder Hintergrundprozessen der Website. Bei mir hat GA4 in einer Woche nur 18 Sitzungen gezählt, während der Server 32.918 Anfragen erhielt.
Wichtig! Überprüfen Sie die Zeitzonen: Das Hosting-Panel, GA4 und das Anfrageprotokoll können die Zeit in verschiedenen Zonen anzeigen. In meinem Fall betrug der Unterschied zwischen dem Protokoll und dem Panel 4 Stunden.
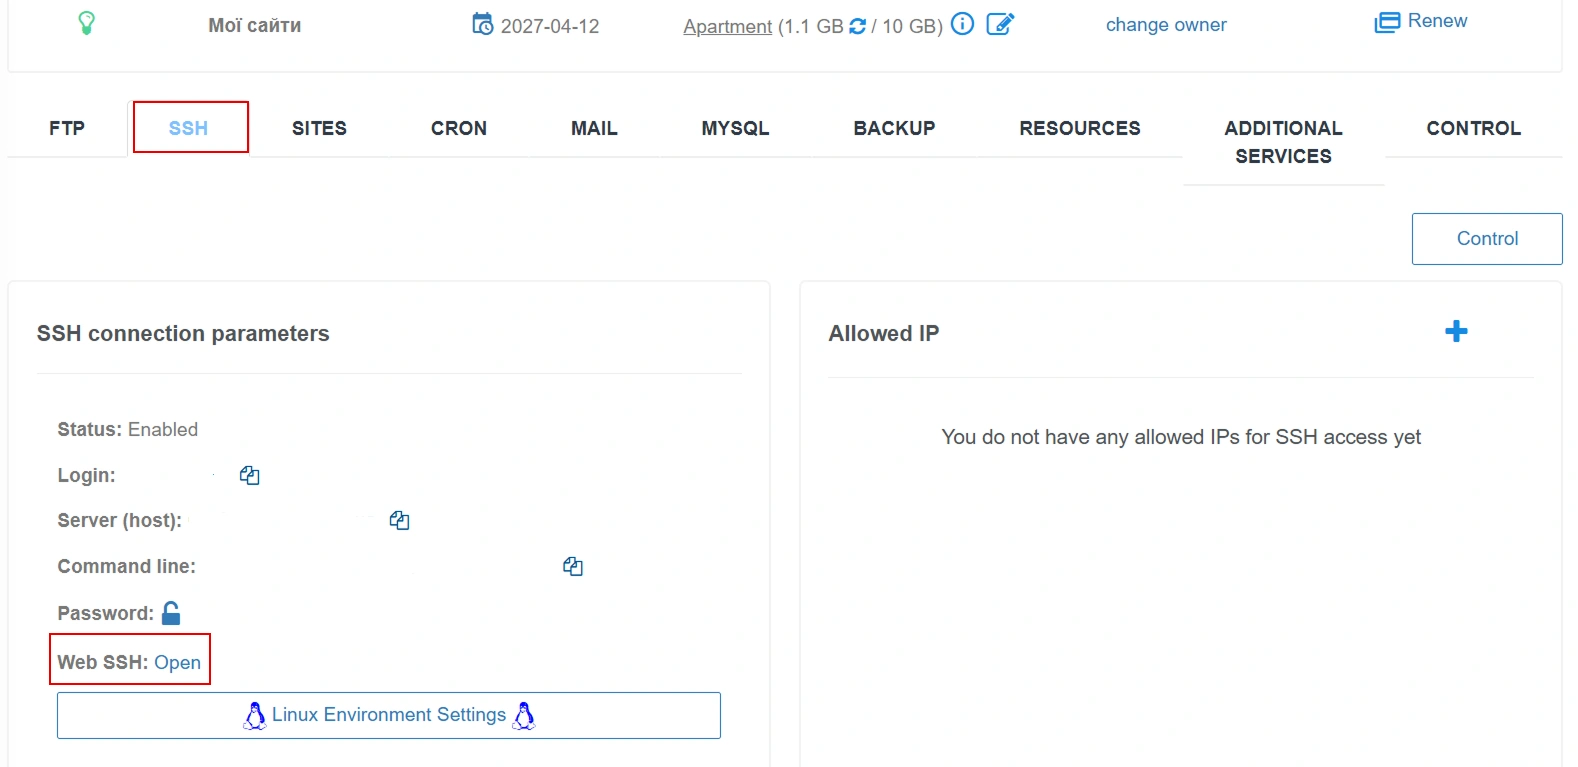
Ermitteln Sie dann, wer die Anfragen stellt. Im Cityhost-Protokoll lässt sich das bequem mit dem GoAccess-Tool analysieren, das über Hosting → Verwaltung → SSH → Web SSH → «Web SSH: Öffnen» gestartet wird. Eine Schritt-für-Schritt-Anleitung finden Sie auf der Seite «Analyse der Zugriffsprotokolle mit GoAccess».

Wir benötigen Abschnitt 6 — Betriebssysteme. Gehen Sie dorthin, indem Sie die Zahl 6 auf der Tastatur drücken, und drücken Sie dann die Eingabetaste, um die Daten zu öffnen. Der Prozentsatz der Anfragen von Bots und deren Namen kann in der Zeile «Crawlers» eingesehen werden.
Im Screenshot von GoAccess vom 5. Oktober wurden 3304 Anfragen an die Website registriert, von denen 596 oder 18,04% in die Kategorie «Crawlers» fielen. Allerdings kann man nicht alle diese Anfragen als Aktivität von AI-Scrapern betrachten: In der sichtbaren Liste fehlen die Namen GPTBot, ClaudeBot oder PerplexityBot, stattdessen sind GoogleApp, GoogleMobile, CFNetwork, TwitterBot und facebookexternalhit aufgeführt. Die Kategorie «Crawlers» definiert nicht, ob die Anfrage mit der Datensammlung für künstliche Intelligenz verbunden ist. Besondere Aufmerksamkeit verdient «Unknown»: Diese Kategorie umfasst 657 Anfragen oder 19,88%, aber ihr Name ermöglicht ebenfalls nicht, deren Herkunft festzustellen. Daher bestätigt dieser Berichtsteil nicht die Aktivitäten von AI-Scrapern und schließt sie nicht aus — für eine Schlussfolgerung muss die vollständige Liste der User-Agent im Protokoll überprüft werden.
Wir suchen AI-Bots direkt in der Protokolldatei über dasselbe SSH-Fenster:
- Schalten Sie die Tastatur auf Englisch um und drücken Sie q, um GoAccess zu verlassen. Lassen Sie das SSH-Fenster geöffnet.
- Fügen Sie diesen Befehl ein und drücken Sie die Eingabetaste (ersetzen Sie MYSITE_NAME durch Ihre Domain und ch50e2c72b durch den Namen Ihres Hosting-Kontos):
awk -F'"' 'tolower($6) ~ /gptbot|oai-searchbot|chatgpt-user|claudebot|claude-searchbot|claude-user|perplexitybot|perplexity-user|meta-externalagent|meta-externalfetcher|meta-webindexer|bytespider|ccbot|amazonbot/ {print $6}' /var/www/ch50e2c72b/logs/MYSITE_NAME.access.log | sort | uniq -c | sort -nr

Im Befehl suchten wir nach 14 Namen von Bots und User-Agents:
- OpenAI: GPTBot, OAI-SearchBot, ChatGPT-User.
- Anthropic: ClaudeBot, Claude-SearchBot, Claude-User.
- Perplexity: PerplexityBot, Perplexity-User.
- Meta: meta-externalagent, meta-externalfetcher, meta-webindexer.
- Andere: Bytespider, CCBot, Amazonbot.
Die Suche in den vollständigen User-Agents lieferte genauere Ergebnisse als die allgemeine Kategorie «Crawlers» in GoAccess: In der überprüften Protokolldatei wurde nur eine Anfrage mit dem Namen OAI-SearchBot — dem Suchbot von OpenAI, gefunden. Andere aufgeführte AI-Bots wurden von dem Befehl nicht entdeckt. Daher deuten diese Daten nicht auf ein massives Scannen der Website durch AI-Scraper hin, und der Anteil der «Crawlers» im Bericht kann nicht mit ihrer Aktivität gleichgesetzt werden.
Die Überprüfung auf AI-Scraping ist also einer der wichtigsten Schritte. Wenn Sie in einer ähnlichen Situation sind, müssen Sie nicht einmal Zeit mit dem Kampf gegen AI-Scraping verschwenden, sondern können einfach Ihre Website optimal optimieren.
Wie man die Last durch AI-Scraping verringert
Entfernen Sie überflüssige Hintergrundaufgaben und aktivieren Sie das Caching, beschränken Sie das Crawlen gewissenhafter Bots über robots.txt, und verlangsamen oder blockieren Sie diejenigen, die sich nicht an die Regeln halten, auf Serverebene, mit Wordfence oder Cloudflare. Es ist unmöglich, sich vollständig vor AI-Scraping zu schützen, aber diese Methoden helfen zumindest, die Last auf dem Hosting der Website zu verringern.
- Entfernen Sie überflüssige Hintergrundaufgaben
- Aktivieren Sie das Seiten-Caching
- Verlangsamen Sie zu aktive Bots in Wordfence
- Fügen Sie Regeln gegen AI-Scraping in robots.txt ein
- Blockieren Sie Bots auf Serverebene
- Aktivieren Sie das Verbot des Trainings in Cloudflare
Entfernen Sie überflüssige Hintergrundaufgaben
WordPress führt Hintergrundaufgaben über WP-Cron aus, das standardmäßig bei jedem Seitenaufruf überprüft wird. Daher kann jede Anfrage eines Bots ebenfalls einen weiteren Zyklus von Aufgaben auslösen. Auf meiner Website verursachten solche Aufgaben 14% aller Anfragen: Das Plugin Link Whisper überprüfte alle 5 Minuten defekte Links, und die Warteschlange Action Scheduler wurde jede Minute gestartet.

Ich empfehle daher:
- Installieren Sie das Plugin WP Crontrol.
- Öffnen Sie Werkzeuge → Cron-Ereignisse.
- Suchen Sie nach Aufgaben, die jede Minute oder alle paar Minuten ausgeführt werden.
- Bestimmen Sie in der Spalte Aktion anhand des Funktionsnamens das Plugin, z. B. gehört Wpil zu Link Whisper.
Wählen Sie schließlich diese Plugins aus und deaktivieren Sie sie, wenn Sie sie nicht verwenden, oder beschränken Sie ihre Funktionalität über die Einstellungen jedes einzelnen Plugins.
Aktivieren Sie das Seiten-Caching
Das Seiten-Caching speichert die bereits generierte Seite als fertige Datei. Wenn ein Bot oder eine Person sie erneut anfordert, startet der Server kein PHP und greift nicht auf die Datenbank zu, sondern gibt einfach die Datei zurück. Auf meiner Website funktioniert dafür das Plugin LiteSpeed Cache.

Gegen AI-Bots funktioniert das Caching schlechter als gegen Menschen. Menschen lesen meist beliebte Seiten, die bereits im Cache sind, während AI-Crawler die gesamte Website durchforsten, einschließlich alter Artikel, die lange nicht mehr besucht wurden. Dennoch scannen sie alle Seiten, sodass die bereits im Cache befindlichen Seiten dennoch helfen, die Last auf dem virtuellen Hosting besser zu verringern als gar kein Caching auf der Web-Ressource.
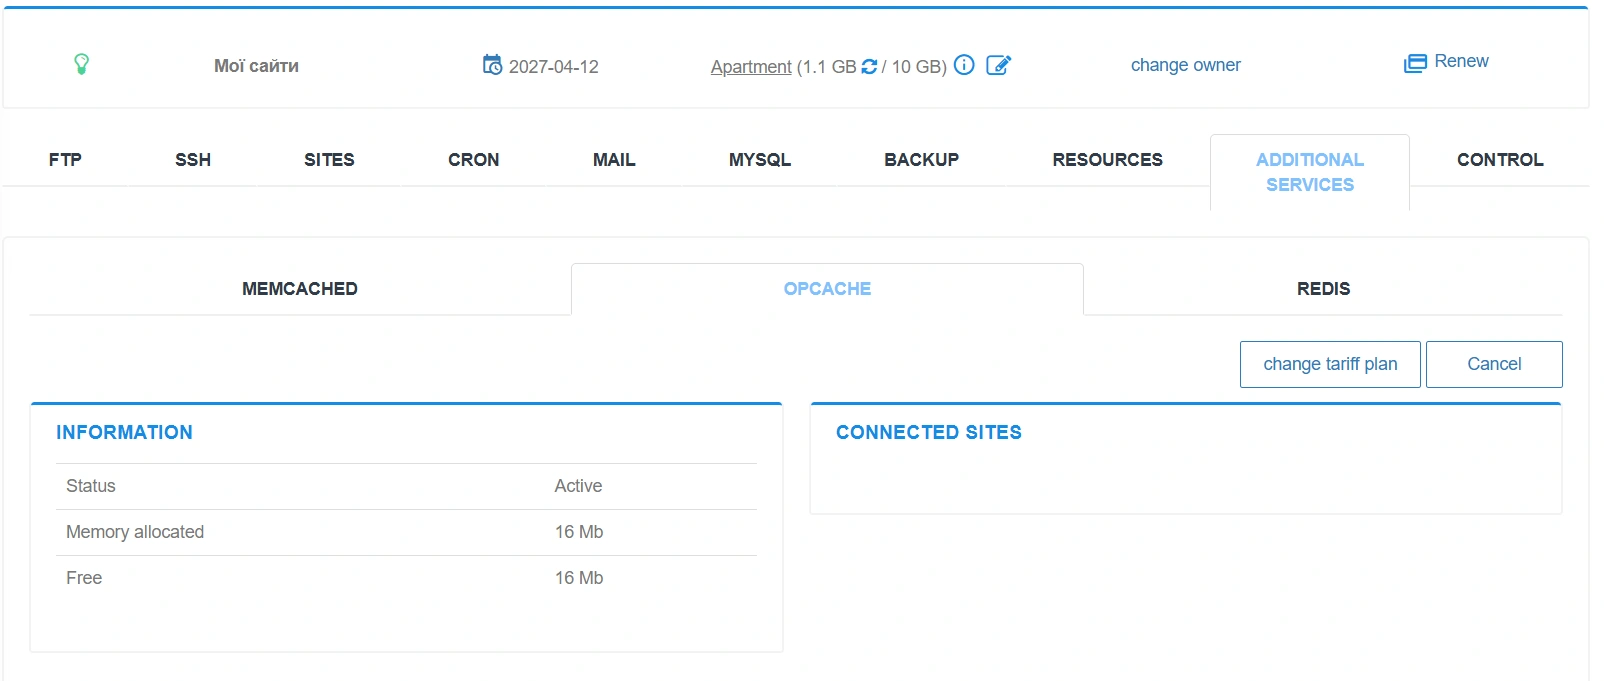
OPcache ist eine andere Art von Cache, die den kompilierten PHP-Code speichert, damit der Server die WordPress-Dateien bei jeder Anfrage nicht erneut lesen muss. Es beschleunigt die Generierung von Seiten, ersetzt jedoch nicht deren Cache, da PHP und Datenbank gleich arbeiten. In Cityhost wird OPcache im Kontrollpanel aktiviert über Verwaltung → Zusätzliche Dienste → OPcache. Für Websites mit häufigen Datenbankanfragen bietet Cityhost auch Memcached und Redis an, die die Ergebnisse von Datenbankanfragen im Speicher speichern.
Lesen Sie auch: Caching-Dienste für Websites: Memcached, OPCache, Redis
Verlangsamen Sie zu aktive Bots in Wordfence
Die kostenlose Version des Plugins Wordfence, das ich seit 2 Jahren benutze, kann die Anfragefrequenz begrenzen:
- Öffnen Sie Wordfence → Alle Optionen → Firewall-Optionen → Ratenbegrenzung.
- Überprüfen Sie, ob die Option Ratenbegrenzung und erweiterte Blockierung aktiviert ist.
- Setzen Sie 240 Anfragen pro Minute für Wenn die Anfragen von jemandem überschreiten.
- Setzen Sie 120 für beide Regeln Seitenaufrufe und 60 für beide Regeln 404s.
- Wählen Sie für jede Regel Throttle it und speichern Sie die Änderungen.

Dies sind Startwerte, die von der Wordfence-Unterstützung empfohlen werden. Throttle bedeutet, dass ein Bot, der das Limit überschreitet, vorübergehend die Antwort 503 erhält, bis er die Anfragefrequenz verringert. Suchmaschinen verstehen eine solche Antwort, daher empfiehlt Wordfence, genau diese Aktion auszuwählen. Limits für Menschen sind ebenfalls wichtig, da Scraper, die sich als Browser tarnen, in diese Kategorie fallen. Stellen Sie auch sicher, dass bei Wie sollten wir Googles Crawler behandeln die Option Verifizierte Google-Crawler nicht von der Ratenbegrenzung betroffen sind, ausgewählt ist.
Wichtig! Die Ratenbegrenzung stoppt plötzliche Spitzen, nicht langsame Scanner. Auf meiner Website stellte der Scanner etwa 10 Anfragen pro Minute und überschritt kein Limit.
Fügen Sie Regeln gegen AI-Scraping in robots.txt ein
robots.txt ist eine Bitte an Bots, kein striktes Regelwerk: Laut TollBit ignorierten im vierten Quartal 2025 30% der Anfragen von AI-Scrapern seine Verbote. Dennoch halten sich Such- und Lernbots großer Unternehmen meist an diese Regeln. Ich habe die Bots in zwei Gruppen unterteilt: Denjenigen, die Leser über AI-Suche bringen, habe ich den Zugang erlaubt, und denjenigen, die Inhalte für das Training von Modellen sammeln, habe ich verboten.
Sie können robots.txt über das Kontrollpanel des Hostings oder SEO-Plugins wie Rank Math SEO bearbeiten. In mein Dokument, das sich speziell auf Bots bezieht, habe ich folgende Zeilen hinzugefügt:
User-agent: *

Content-Signal: search=yes, ai-train=no, ai-input=yes

User-agent: OAI-SearchBot

User-agent: ChatGPT-User

User-agent: Claude-SearchBot

User-agent: Claude-User

User-agent: PerplexityBot

User-agent: Applebot

User-agent: DuckAssistBot

User-agent: MistralAI-User

Allow: /

User-agent: GPTBot

User-agent: ClaudeBot

User-agent: Google-Extended

User-agent: Google-CloudVertexBot

User-agent: Applebot-Extended

User-agent: Bytespider

User-agent: CCBot

User-agent: Amazonbot

User-agent: FacebookBot

User-agent: meta-externalagent

Disallow: /
Die Zeile Content-Signal informiert, dass der Inhalt für die Suche und Antworten von AI verwendet werden kann, jedoch nicht für das Training von Modellen. Platzieren Sie sie in der Gruppe User-agent: * neben den vorhandenen Regeln von WordPress.
Wichtig! Google-Extended hat keinen Einfluss auf die Google-Suche und AI-Übersichten, aber eine Regel umfasst sowohl das Training von Gemini als auch dessen Antworten mit Quellenangaben. Wenn Sie es verbieten, verlieren Sie auch die Zitationen in Gemini. Wenn die Sichtbarkeit in Gemini für Sie wichtiger ist als der Schutz vor dem Training, verschieben Sie Google-Extended in die Gruppe Allow.
Die Erlaubnis in robots.txt hilft nicht, wenn der Bot durch den Serverschutz blockiert wird. In meinen Protokollen erhielten die erlaubten OAI-SearchBot und PerplexityBot bei etwa einem Drittel der Anfragen eine 403-Verweigerung. Überprüfen Sie daher nach den Änderungen im Protokoll, welche Antwort die Such-AI-Bots erhalten. Wenn es 403 ist, wenden Sie sich an den Hosting-Support, um sie in die Ausnahmen aufzunehmen.
Blockieren Sie Bots auf Serverebene
Wenn ein Bot robots.txt ignoriert, blockieren Sie ihn auf Serverebene: Dann erhält er die Antwort 403, noch bevor WordPress gestartet wird. Überprüfen Sie zunächst das Protokoll, denn auf meiner Website erhielten GPTBot und CCBot bereits 403 ohne meine Regeln.
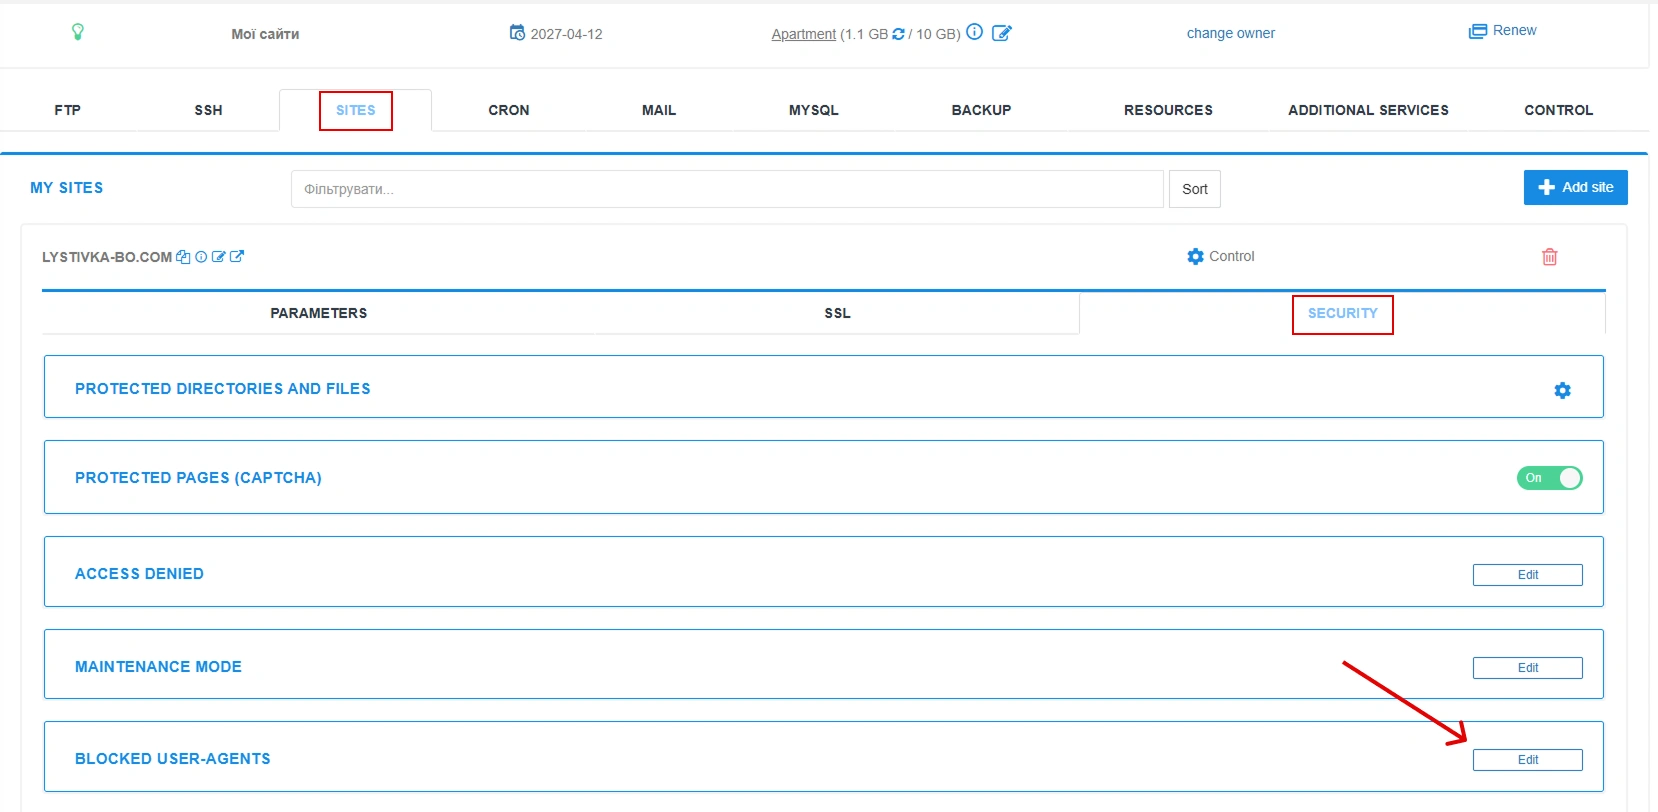
Gehen Sie dazu folgendermaßen vor:
- Öffnen Sie cp.cityhost.ua → Tab «Websites».
- Gehen Sie bei der gewünschten Website zum Tab «Sicherheit».
- Klicken Sie im Abschnitt «Blockierte User-Agents» auf «Bearbeiten».
- Fügen Sie am Ende der Liste den Namen des Bots hinzu und speichern Sie die Änderungen.
Cityhost blockiert bereits standardmäßig verbreitete schädliche Bots. Überprüfen Sie, ob die Blockierung funktioniert hat, mit dem Web SSH-Befehl curl -I "https://ihre-website.com" -A "CCBot": In der Antwort sollte der Code 403 sein.
Wichtig! Fügen Sie Googlebot, bingbot und Such-AI-Bots nicht zur Liste hinzu, sonst verliert die Website den Verkehr aus der Suche und die Sichtbarkeit in AI-Antworten. Und das Blockieren von Scraper, die sich als Browser tarnen, stoppt nicht durch User-Agent.
Lesen Sie auch: Schädliche Bots: Wie sie der Website schaden und wie man sie blockiert
Aktivieren Sie das Verbot des Trainings in Cloudflare
Cloudflare stoppt Bots, noch bevor sie zum Hosting gelangen, und die benötigten Tools sind im kostenlosen Tarif verfügbar, den ich seit 1,5 Jahren benutze:

- Fügen Sie die Website zu Cloudflare hinzu und ändern Sie die NS-Server der Domain auf die, die es ausgibt.
- Öffnen Sie Ihre Domain → Sicherheit → Einstellungen.
- Wählen Sie im Gruppenfilter Bot-Verkehr aus.
- Klicken Sie auf AI-Bot-Richtlinien konfigurieren.
- Wählen Sie für Training Disallow und für Suche und Agent Allow (nicht blockieren).
- Klicken Sie auf Speichern.
Die Option Disallow blockiert Trainingsbots von Amazon, Anthropic, Meta und OpenAI, während Googlebot, Applebot und Bingbot weiterhin die Website für die Suche indizieren.

Der Schalter Enable Bot Preference Sync fügt die Cloudflare-Regeln an den Anfang von robots.txt hinzu. Wenn Sie Google-Extended und Applebot-Extended bereits in Ihrem eigenen robots.txt verboten haben, wie oben beschrieben, lassen Sie ihn deaktiviert, damit die Regeln nicht dupliziert werden.
Wichtig! Ab dem 15. September 2026 stoppen die Optionen Block und Block auf Seiten mit Werbung für Training auch Googlebot, Bingbot und Applebot. Wählen Sie daher für das Verbot des Trainings unbedingt Disallow.
Ist es möglich, schädliches AI-Scraping vollständig zu stoppen
Nein. Ein Teil der Bots tarnt sich als gewöhnliche Besucher, und auf einer kleinen Website ist es unmöglich, alle zu erkennen. Cloudflare beschrieb, wie Perplexity nach der Blockierung auf den User-Agent des Browsers Chrome wechselte und die IP-Adressen änderte, und dies konnte nur nach einer Untersuchung von Daten von Millionen von Websites festgestellt werden. Dennoch ermöglichen die beschriebenen Methoden, einen Großteil der Bots loszuwerden.
Beeilen Sie sich nur nicht mit Maßnahmen. Mein Test zeigte, dass die Angst vor AI-Scraping oft größer ist als der tatsächliche Schaden: AI-Bots verursachten nur 3,2% der Anfragen, während die Prozessorlast von Schwachstellenscannern und Hintergrundaufgaben von WordPress verursacht wurde. Blockieren Sie daher nicht alle wahllos. Finden Sie zuerst heraus, was genau Ihr Hosting belastet, und lösen Sie dieses spezifische Problem, und beschränken Sie AI-Bots nur dann, wenn Sie sie tatsächlich in den Protokollen finden. Und überprüfen Sie das Anfrageprotokoll mindestens einmal im Monat, um neue Bots rechtzeitig zu bemerken.