- Was ist Shared-Hosting und warum benötigte es neue Lösungen
- Was haben CMS an der Funktionsweise von Websites geändert
- Isolierung von Nachbarn auf einem Shared-Server
- Was bringt das für die Optimierung
Das frühe Web war ziemlich einfach: Websites bestanden aus statischen HTML-Seiten, die der Server auf Anfrage des Browsers ausgab, und das war's. Im Laufe der Zeit begannen sie, sich mit Videos, Datenbanken, großen Produktkatalogen und Sammlungen von Dateien zu füllen. Es entstanden persönliche Konten, Warenkörbe, Online-Zahlungen und andere Funktionen, die immer mehr Ressourcen benötigten. Zusammen mit den Websites musste sich auch das Hosting weiterentwickeln: leistungsfähiger werden und neue Möglichkeiten zur Verarbeitung von Anfragen finden. Es war eine Art Wettlauf – sobald im Web etwas Neues auftauchte, mussten die Server lernen, damit umzugehen.
Im Jahr 1998 konnte eine typische Website aus mehreren HTML-Dateien bestehen. Nach 10 Jahren, im Jahr 2008, konnte eine WordPress-Seite bereits Hunderte von PHP-Funktionen und Dutzende von SQL-Abfragen ausführen. Im Jahr 2018 kamen komplexe JavaScript-Frameworks, zahlreiche APIs, externe Dienste, Videos und personalisierte Inhalte hinzu. Bis 2028 werden Websites wahrscheinlich noch aktiver KI nutzen, einen Teil des Inhalts in Echtzeit generieren und die Benutzeroberfläche an den jeweiligen Benutzer anpassen. Das ist eine enorme Evolution, und sie dauert an.
Was ist Shared-Hosting und warum benötigte es neue Lösungen
Shared-Hosting ist eine der häufigsten Arten von Hosting. Darauf werden viele Dinge gehostet – von persönlichen Blogs bis hin zu Websites kleiner Geschäfte. In der Regel bieten Hosting-Anbieter dieses Typs sofort die Möglichkeit, eine CMS zu installieren oder eine vorinstallierte CMS zu erhalten. Wahrscheinlich haben Sie, wenn Sie nach Hosting gesucht haben, Angebote wie „WordPress-Hosting“, „Online-Shops auf Website-Baukästen“ usw. gesehen.
Zu Beginn der Internetgeschichte musste man, um eine Website zu hosten, einen eigenen Server besitzen oder ihn vollständig mieten. Shared-Hosting löste das Problem der hohen Kosten solcher Server. Wenn Sie beispielsweise handgefertigtes Papier in einem kleinen Geschäft verkaufen möchten, sind Tausende von Dollar für einen persönlichen Server einfach nicht erschwinglich. Aber abgesehen davon – Sie würden nie alle seine Ressourcen nutzen. Überflüssig und teuer. Daher ermöglichte die neue Art des Hostings, Hunderte von Websites auf einem Server anstelle von nur einer zu hosten, wodurch die Kosten erheblich gesenkt wurden.
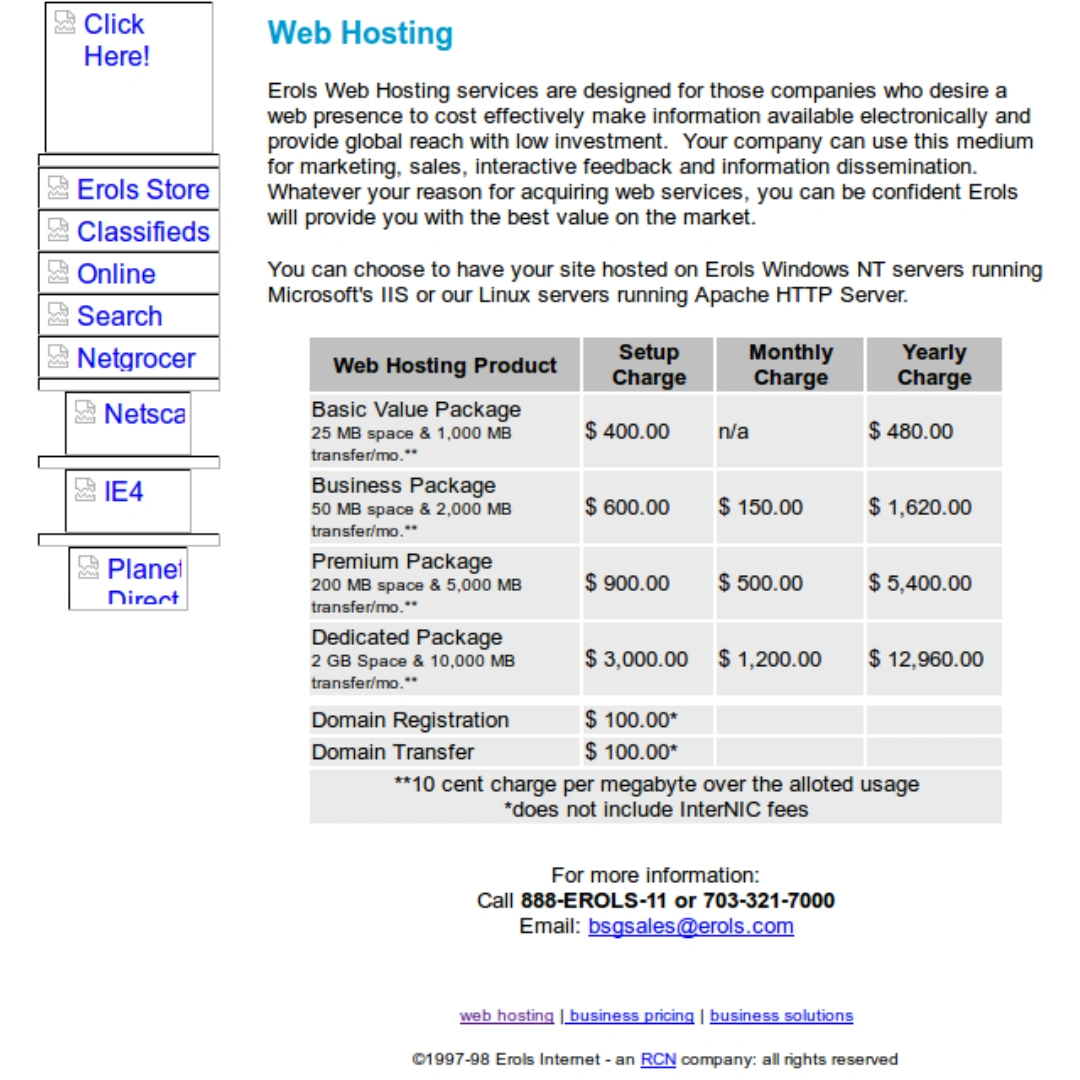
Preise von Erols Internet für Hosting in den Jahren 1997–1998. Selbst das Basispaket mit 25 MB Speicherplatz kostete 400 USD für die Verbindung und weitere 480 USD pro Jahr. Solche Preise erscheinen drakonisch, aber damals war Business-Hosting ein komplexer und teurer Service, der hauptsächlich auf Unternehmen ausgerichtet war. Quelle: JeremyPerson.com.
Die Essenz ist einfach: Anstatt einen separaten Computer für jeden Kunden bereitzustellen, teilt ein Server seine Ressourcen zwischen vielen Websites. Alle nutzen denselben Prozessor, Arbeitsspeicher, Festplatte und Netzwerkverbindung. Warum war das möglich? Es gibt zwei Antworten: die Besonderheiten der Last und die Idee des virtuellen Hostings.
Die meisten Websites erzeugen einen Großteil der Zeit eine geringe Last. Besucher kommen unregelmäßig, und die Spitzenzeiten verschiedener Projekte fallen normalerweise nicht zusammen. Daher können die Ressourcen eines großen Servers auf viele Websites verteilt werden: Während eine mehr Ressourcen benötigt, benötigen die anderen sie möglicherweise einfach nicht.
Das zweite, was dieses Modell möglich machte, war der Mechanismus des virtuellen Hostings.
Eine wichtige Rolle in der Entwicklung des Shared-Hostings spielte der Standard HTTP/1.1, der 1997 veröffentlicht wurde. Er machte den Host-Header obligatorisch, über den der Browser dem Server mitteilt, auf welche Domain er zugreift. Dadurch konnte ein Server und sogar eine IP-Adresse viele verschiedene Websites bedienen. Dies senkte nicht nur die Kosten für das Hosting, sondern half auch, die Erschöpfung von IPv4-Adressen zu verlangsamen.
Der Webserver bestimmt, auf welche Domain der Benutzer zugreift, und liefert die entsprechende Website. Für den Eigentümer sieht es so aus, als hätte er einen eigenen Raum für sein Projekt, obwohl Prozessor, Speicher und Festplatte tatsächlich zwischen Dutzenden oder Hunderten von Kunden aufgeteilt werden.
Genau dieses Modell machte das Web wirklich zugänglich. Eine Website zu starten bedeutete nicht mehr, einen eigenen Server zu kaufen – es genügte, einen kleinen Teil eines bereits bestehenden zu mieten.
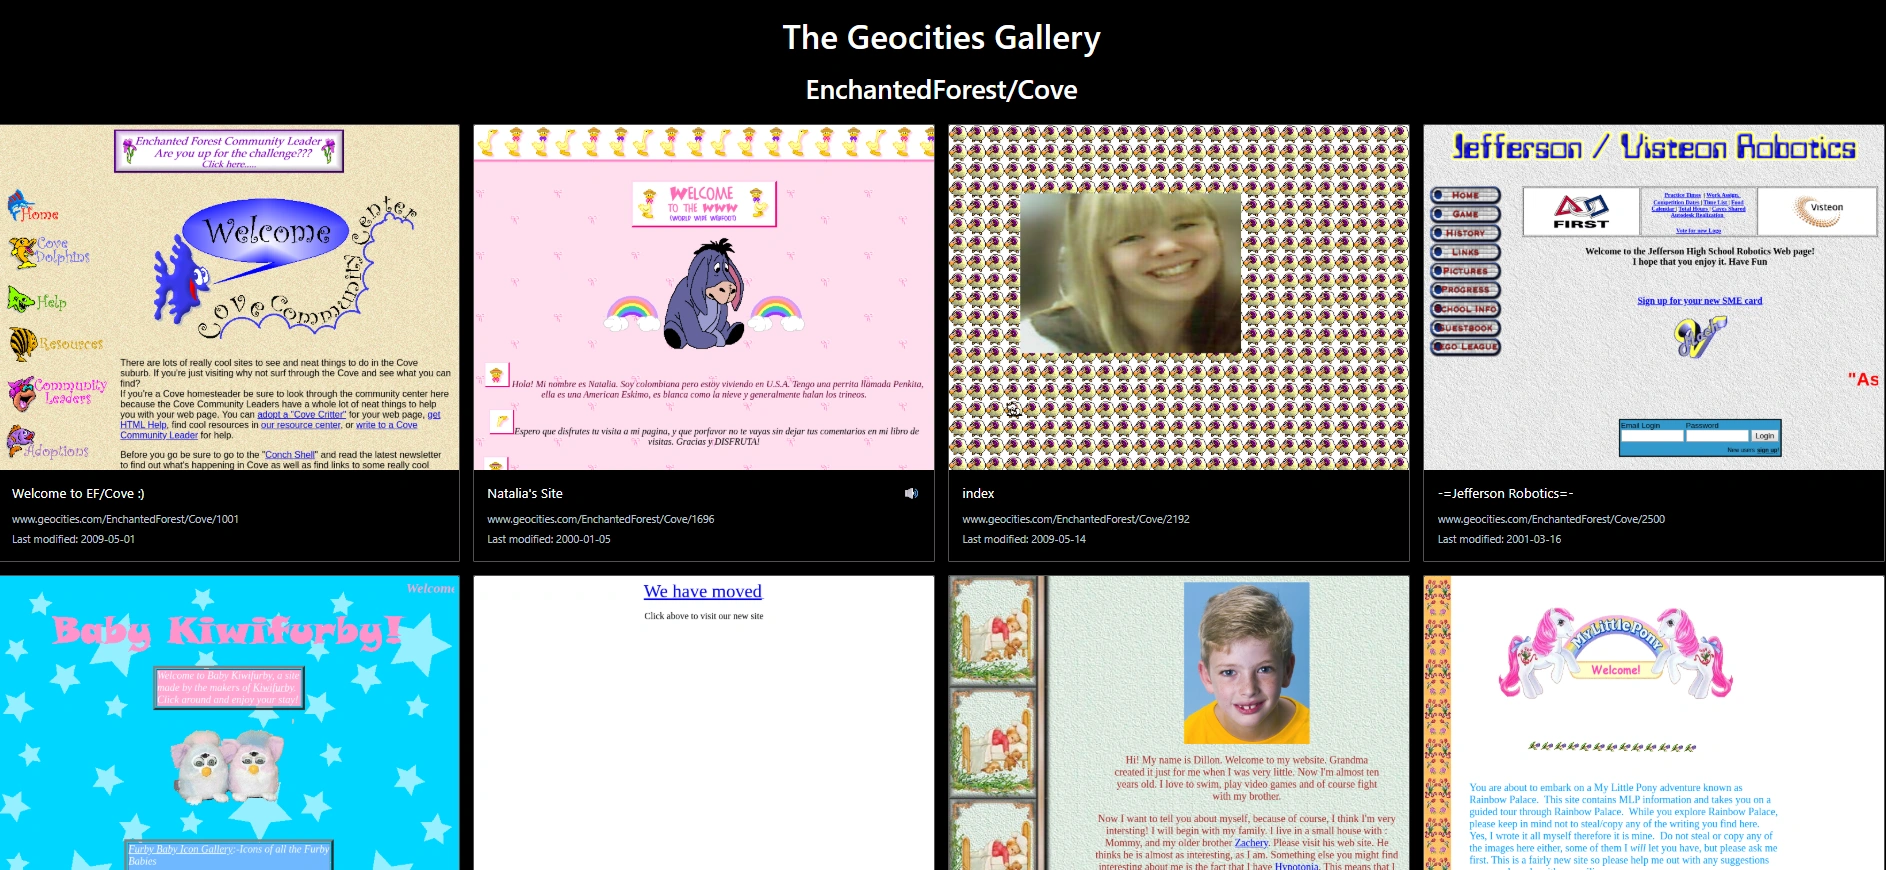
Eine besondere Seite in der Geschichte des zugänglichen Webs war GeoCities – einer der bekanntesten kostenlosen Hosting-Dienste der 1990er Jahre. Benutzer erhielten 1 MB Speicherplatz und konnten ihre eigene Seite erstellen, ohne einen Server kaufen oder tiefgehende technische Kenntnisse haben zu müssen. Die Websites wurden nach thematischen „Nachbarschaften“ verteilt: Zum Beispiel lebten Seiten über Technologie in SiliconValley, während solche über Filme und Prominente in Hollywood waren. Infolgedessen verwandelte sich GeoCities in eine riesige digitale Stadt mit bunten Hintergründen, animierten GIFs, Besuchszählern und Aufschriften wie „Under construction“. Mehr über diesen legendären Dienst und das Internet der 1990er Jahre haben wir in unserem Video erzählt.
Aber ein solches System funktioniert nur gut, wenn alle „Nachbarn“ ungefähr die gleiche Menge an Ressourcen verbrauchen. Mit der Verbreitung dynamischer Websites und CMS wurde es jedoch immer schwieriger, dieses Gleichgewicht aufrechtzuerhalten. Ein Projekt konnte Hunderte von PHP-Prozessen erzeugen, ständig auf die Datenbank zugreifen oder die Last während eines Besucheransturms drastisch erhöhen.
Was haben CMS an der Funktionsweise von Websites geändert
CMS wurden zu einer der häufigsten Arten dynamischer Websites. Im Gegensatz zu statischen Seiten generieren sie HTML mithilfe von Programmcode, Daten aus der Datenbank und installierten Modulen.
Für uns als Benutzer ist es egal, was im Inneren der Website passiert. Wir bemerken Probleme, denken aber nie über die internen Prozesse nach, es sei denn, die Website hängt mitten beim Ticketkauf.
Ursprünglich bestanden die meisten Websites aus gewöhnlichen HTML-Dateien. Wenn der Text auf einer Seite geändert werden musste, öffnete der Administrator die Datei und bearbeitete sie manuell.
CMS (Content Management System, Inhaltsverwaltungssystem) änderten dieses Modell. Anstatt aus einer Reihe von fertigen Seiten zu bestehen, wurde die Website zu einem Programm. Texte, Seitenstruktur und Einstellungen begannen, in der Datenbank gespeichert zu werden, während Bilder und andere Dateien im Speicher der Website abgelegt wurden. Bei jeder Anfrage stellte die CMS aus diesen Komponenten die fertige Seite zusammen.
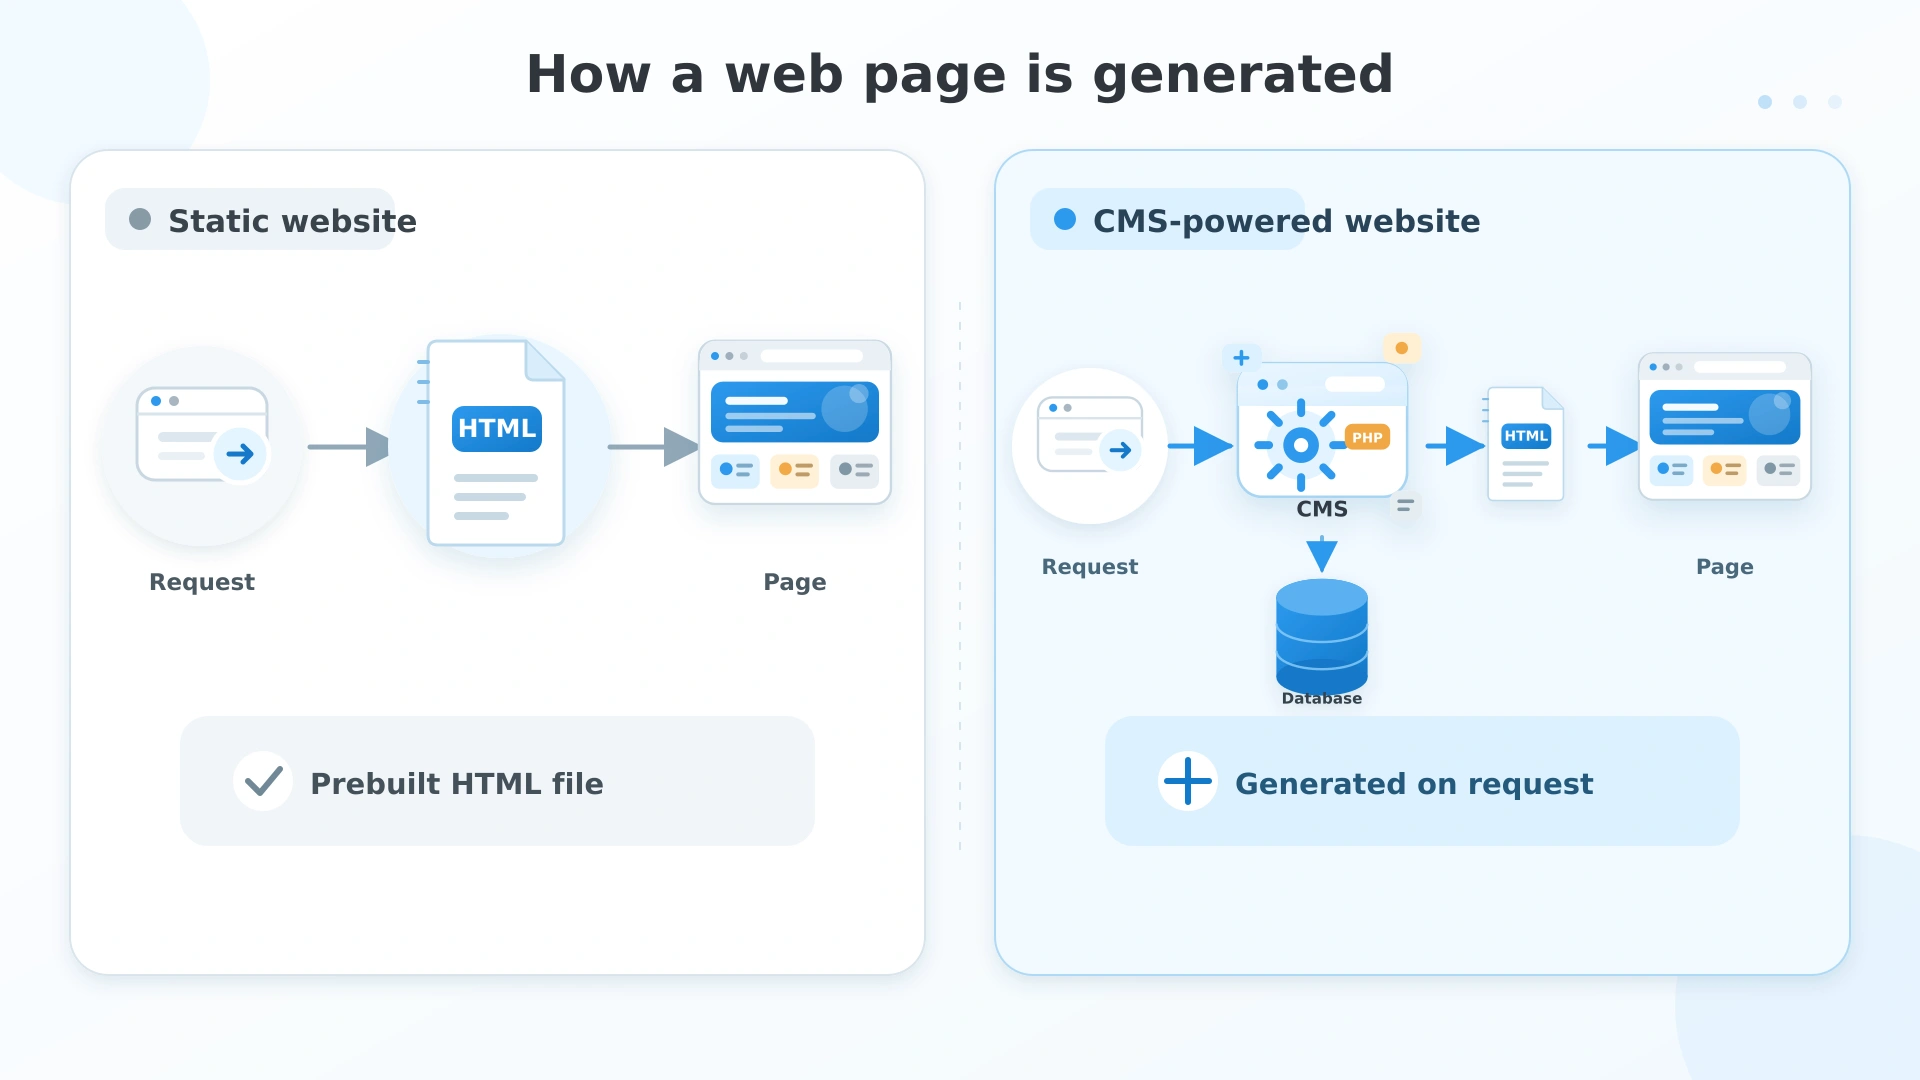
Für den Website-Besitzer bedeutete dies, dass er kein HTML mehr kennen musste, um eine Nachricht zu veröffentlichen oder einen Artikel zu schreiben. Man konnte es selbst schaffen oder einen Content-Manager einstellen, der kein Webdesigner ist, günstiger ist und schnell zurechtkommt. Für den Server wurde jedoch jeder Seitenaufruf plötzlich zu einer deutlich komplizierteren Aufgabe: Wir erinnern uns, dass der Server nicht einfach die Seite aus der Bibliothek ausgab, sondern sie neu generierte. Daher mussten diese Prozesse verbessert werden, um Ressourcen zu sparen und den Weg zu vereinfachen.
OPcache: Einsparung von CPU-Zeit
Wenn ein Benutzer eine WordPress-Seite öffnete, führte der Server jedes Mal dieselbe Arbeit aus. So lief es ab: PHP las Dutzende von Dateien von der Festplatte, verwandelte sie in eine interne Darstellung (Bytecode) und führte sie dann aus.
Das bedeutet, dass der Server selbst dann, wenn der Code der Website überhaupt nicht geändert wurde, bei jeder Anfrage dieselbe Vorbereitungsarbeit leisten musste. OPcache begann, den bereits kompilierten Code im Speicher zu speichern. In der Folge konnte PHP das Programm sofort ausführen, ohne mehrere kostspielige Schritte zu durchlaufen.
Tatsächlich hörte der Server auf, jedes Mal „das Buch zu lesen“, bevor er dem Benutzer antwortete.
Der erste Opcode-Cache für PHP wurde 1998 von der Firma Zend Technologies erstellt. Er hieß Zend Optimizer (später Zend Optimizer+). Im Jahr 2013 schlug der Mitbegründer des Unternehmens und einer der Mitautoren des modernen PHP, Zeev Suraski, vor, den Quellcode von Optimizer+ zu öffnen und ihn in PHP 5.5 zu integrieren. Nach der Integration erhielt die Komponente den Namen OPcache.
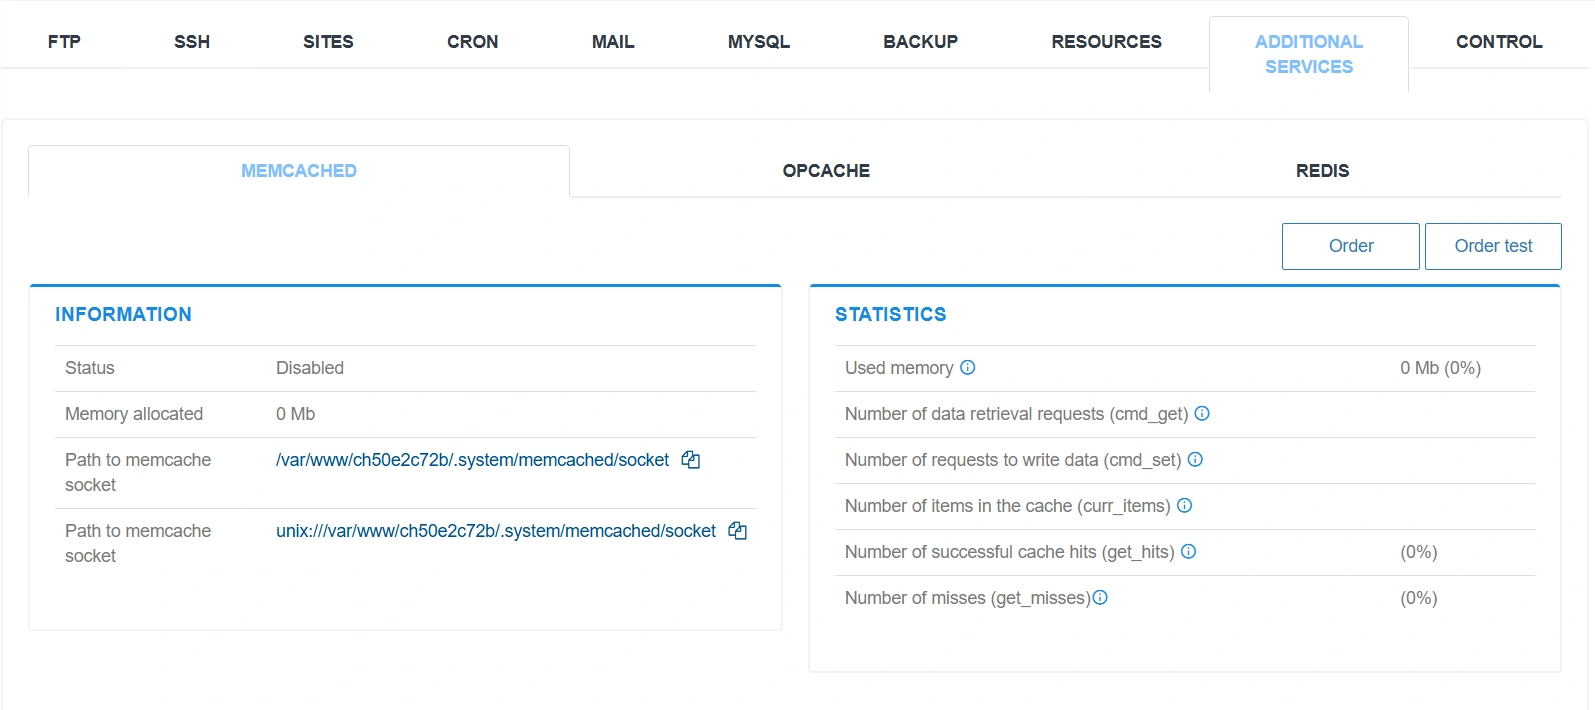
Übrigens gibt es im Kontrollpanel des Hostings Cityhost.ua die Möglichkeit, Caching-Tools im Abschnitt Websites – Zusätzliche Dienste zu aktivieren.
Lesen Sie auch: Caching-Dienste für Websites: Memcached, OPCache, Redis
Page Cache: Einsparung bei der Seitenregeneration
Für die meisten Besucher ist die Hauptseite gleich. Aber wir erinnern uns wieder daran, dass die CMS jedes Mal die Datenbank neu abfragen, Plugins anfragen und HTML neu generieren kann.
Daher war die nächste Frage, warum eine Seite von Grund auf neu erstellt werden sollte, die fast immer gleich ist. Auch sie musste zwischengespeichert werden. Nach der ersten Anfrage speicherte der Server bereits das fertige HTML, und die CMS musste überhaupt nicht gestartet werden, um diese Seite anzuzeigen. Weniger Last auf dem Prozessor und den Datenbanken, blitzschnelle Antwort der Website – alle sind glücklich.
Aber was, wenn sich die Seite geändert hat? Zum Beispiel erschien im Blog ein neuer Artikel, der im Nachrichtenblock auf der Hauptseite angezeigt werden muss – und das ist nicht mehr dieselbe Seite. Und hier musste die Optimierung jedes Mal die Antwort auf die Frage finden, wann die CMS überhaupt nicht gestartet werden kann und wann die Hauptseite noch einmal neu generiert werden muss.
So entstand das Meme über die schwierigsten Dinge in der Programmierung. Das Zitat stammt von Phil Carlton (einem Mitarbeiter von Xerox PARC): „In der Programmierung gibt es nur zwei wirklich schwierige Dinge: Cache-Invalidierung und Benennung“.
Object Cache: Einsparung bei Datenbankabfragen
Eine dynamische Website greift ständig auf die Datenbank zu, egal was passiert, vom Kommentar bis zur Änderung der Produktkategorie. Und die Zugriffe sind wiederum kostspielig, aber oft sinnlos, da eine Seite monatelang dieselbe sein kann.
Object Cache ermöglicht es, die Ergebnisse einzelner Datenbankabfragen zu speichern. Wenn die Anwendung bereits weiß, welche Kategorien existieren oder welchen Wert eine bestimmte Einstellung hat, macht es keinen Sinn, MySQL jedes Mal zu belästigen.
Hier kann man auf eine weitere interessante Geschichte eingehen – Memcached, ein System, das nicht für CMS entwickelt wurde, aber ein ähnliches Problem löste. Es wurde für Livejournal erfunden, eine Website mit einer riesigen Anzahl persönlicher Tagebücher, auf der früher alle unsere Bekannten waren. Sie hatten ein Problem: Die Datenbank konnte die Last nicht mehr bewältigen, obwohl eine riesige Anzahl von Anfragen dieselben Ergebnisse zurückgab. Der Ingenieur Brad Fitzpatrick und seine Kollegen schrieben einen kleinen Dienst, der einfach die Antworten im Arbeitsspeicher speicherte. Diese Lösung stellte sich schnell als universell heraus und wurde von praktisch allen großen PHP-Projekten übernommen.
Lesen Sie auch: Plugins für WordPress, die man sofort installieren sollte – Checkliste für den Start der Website
PHP-FPM: Einsparung bei Prozessen
Selbst wenn der Code bereits kompiliert war und ein Teil der Daten zwischengespeichert war, blieb noch ein Problem.
Zu Beginn arbeitete PHP normalerweise über CGI (Common Gateway Interface). Für jede HTTP-Anfrage startete der Webserver einen separaten PHP-Prozess, führte das Skript aus und beendete sofort dessen Arbeit. Hunderte von Besuchern auf der Website bedeuteten Hunderte neuer Prozesse, was die Last erheblich erhöhte.
Der erste Schritt war FastCGI. Seine Idee war einfach: PHP nicht für jede Anfrage neu zu starten. Stattdessen hielt der Server mehrere bereits vorbereitete PHP-Prozesse und übermittelte einfach neue Anfragen an sie.
Später erhielt PHP PHP-FPM (FastCGI Process Manager) – einen Prozessmanager, der automatisch den Pool von PHP-Prozessen je nach Last erstellte, beendete und skalierte.
Infolgedessen hörte der Server auf, Ressourcen für die ständige Erstellung neuer Prozesse auszugeben und konnte eine große Anzahl gleichzeitiger Besucher viel effizienter bedienen.
Isolierung von Nachbarn auf einem Shared-Server
Im Shared-Hosting arbeiten Hunderte von Websites auf einem Server und nutzen gemeinsame Ressourcen. Wenn eine von ihnen plötzlich einen großen Anstieg des Traffics erhält oder ein fehlerhaftes Skript ausführt, kann dies alle Nachbarn beeinträchtigen.
Im Jahr 2010 schlug das Unternehmen CloudLinux unter der Leitung von Igor Seletskiy eine Lösung vor. Obwohl die Mechanismen zur Isolierung von Prozessen in Linux bereits existierten, passte CloudLinux sie an die Bedürfnisse von Hosting-Anbietern an. Die Technologie LVE (Lightweight Virtual Environment) ermöglichte es, separate Limits für CPU, Arbeitsspeicher, Festplatte und Anzahl der Prozesse für jedes Konto festzulegen.
Nach dieser Änderung konnte die problematische Website nur sich selbst verlangsamen, während der Server normal weiterarbeitete. An dieser Stelle kann der Hoster anbieten, Ressourcen für ein Konto zu kaufen, das systematisch überlastet ist.
Was bringt das für die Optimierung
Jetzt wird es ein illustratives Modell geben. Ich habe KI gebeten, abzuschätzen, wie viele Ressourcen eine Website ohne Optimierung verbrauchen könnte, wenn sie mit moderner Grafik, Katalogen und Plugins arbeitet. Dies sind keine genauen Zahlen, da alles davon abhängt, welche CMS auf der Website steht, welche Plugins verwendet werden, wie viele Menschen sie besuchen usw. Aber die Größenordnung der Zahlen könnte ähnlich sein.
Nehmen wir eine hypothetische beliebte Nachrichten-Website mit eine Million Seitenaufrufen pro Tag. Das sind im Durchschnitt etwa 12 Aufrufe pro Sekunde, aber während der Spitzenzeiten kann es zehnmal mehr sein.
Angenommen, ohne irgendwelche Optimierungen benötigt die Erstellung einer Seite durch die CMS etwa 300 Millisekunden. In dieser Zeit sind die Ausführung des PHP-Codes, die Arbeit der Plugins, die Abfragen an die Datenbank und die HTML-Generierung enthalten.
Pro Tag würde das bedeuten:
1 000 000 × 0,3 Sekunden = 300 000 Sekunden, oder etwa 83 Stunden Gesamtverarbeitungszeit für Anfragen.
Stellen wir uns nun vor, dass die Website einen modernen Optimierungs-Stack verwendet.
- 95% der Seiten werden direkt aus dem Page Cache ausgeliefert und benötigen nur 2 Millisekunden zur Verarbeitung.
- Die restlichen 5% werden tatsächlich von der CMS generiert, aber dank OPcache, Object Cache und PHP-FPM benötigt ihre Verarbeitung etwa 100 Millisekunden.
Die durchschnittliche Verarbeitungszeit einer Anfrage würde dann betragen:
95% × 2 ms + 5% × 100 ms = 6,9 ms.
Für eine Million Aufrufe wären das bereits:
1 000 000 × 0,0069 Sekunden = 6 900 Sekunden, oder etwa 1,9 Stunden Gesamtverarbeitungszeit für Anfragen.
In diesem vereinfachten Modell beträgt der Unterschied über 40 Mal.
In Geld könnte der Unterschied nicht wie „Server für 50 USD gegen Server für 2 USD“ aussehen, da die Kosten Arbeitsspeicher, Datenbank, Festplatten, Backup, Netzwerk und die Fähigkeit, Spitzen zu bewältigen, umfassen. Dennoch ist die Größenordnung anschaulich: Ohne diese Optimierungen könnte eine beliebte CMS-Website eine Farm aus Dutzenden von Serverkernen benötigen, während die optimierte Version mit wenigen auskommt.
Lesen Sie auch: TOP-3 CMS zur Erstellung eines Online-Shops
Das ermöglicht es, gewöhnliche moderne Websites, die tatsächlich ständig eine Menge Aufgaben ausführen, auf günstigen kleinen Hostings zu hosten, und den Benutzern – Antworten von der Website in Sekunden zu erhalten und nicht in Stunden, wie es früher der Fall war, wenn die Website überlastet war. Der Schutz funktioniert nicht immer perfekt. Wir können immer noch eine Website am Tag des Verkaufs von begehrten Tickets, der Bestellung eines erwarteten Buches oder wenn eine heiße Nachricht auftaucht, zum Absturz bringen. Dennoch kommen die Server meistens auch mit einem großen Ansturm von Besuchern zurecht, die massenhaft etwas bestellen oder scrollen.
Es ist schwer vorstellbar, wie viele Ressourcen täglich insgesamt gespart werden. Allerdings gibt es jetzt künstliche Intelligenz, die unermesslich viel Strom, Speicher und Wasser zur Kühlung verbraucht. Aber wahrscheinlich wird sich auch ihre Entwicklung in Richtung Optimierung bewegen. Oder nicht?