- Ein wenig Katastrophengeschichte
- Drei Hauptprinzipien moderner Infrastruktur
- Geschichten des (Nicht-)Erfolgs
Wir alle können uns an einige großangelegte Ausfälle erinnern, die uns betroffen haben. Sie zeigten gut, wie zerbrechlich das moderne Leben ist. Wie unbequem es wird, wenn das Energiesystem durch Beschuss abgeschaltet wird: Das hat wahrscheinlich jeden betroffen — Kälte, kein Internet, keine Aufzüge, teilweise — kein Wasser. Aber es gab auch kleinere Katastrophen, die wir bemerkt haben und die innerhalb weniger Tage überwunden wurden.
Zum Beispiel erinnern wir uns alle daran, wie am 12. Dezember 2023 Kyivstar nicht mehr funktionierte. Man konnte nicht telefonieren, das mobile Internet nutzen, und zusammen mit dem Netzwerk des Betreibers funktionierten vorübergehend auch einige Geldautomaten, POS-Terminals und andere Dienste, die davon abhingen. Die Wiederherstellung dauerte mehrere Tage. Als Mutter, die ihr Kind in den Kindergarten bringt und ständig erreichbar bleibt für den Fall, dass es krank wird oder eine andere Notlage eintritt, erinnere ich mich, wie unangenehm es war, ohne Empfang durch die Stadt zu laufen.
Und es gab auch Katastrophen, die nicht eingetreten sind.
Zum Beispiel versuchten im April 2022 russische Hacker, das ukrainische Energiesystem abzuschalten. Der Angriff konnte buchstäblich im letzten Moment gestoppt werden. Die meisten Ukrainer erfuhren davon nicht einmal.
Die moderne IT-Branche kämpft gegen Ausfälle, bevor sie eintreten. Und das beste Ergebnis dieser Arbeit ist, wenn wir nicht einmal ahnen, dass sie stattfindet, weil die Systeme so gut dupliziert sind, dass die Reparatur unbemerkt bleibt.
Das hängt damit zusammen, dass Ingenieure normalerweise nicht auf Erfolg, sondern auf Misserfolg planen. Fällt ein Rechenzentrum aus — die Website funktioniert; das Video stoppt nicht, wenn wir das Kabel durchtrennen; Dateien verschwinden nicht mit einer defekten Festplatte des Servers.
Diese Logik gilt auch für eine gewöhnliche Website. Bei der Auswahl eines Hostings oder eines virtuellen Servers sollte man nicht nur auf Geschwindigkeit und Speicherkapazität achten, sondern auch darauf, was mit dem Projekt im Falle eines Ausfalls passiert. Welche Backups sind verfügbar, wo werden sie gespeichert, wer und wie wird die Arbeit wiederherstellen — diese Fragen sollten besser noch vor dem ersten Ausfall gestellt werden.
Für uns bei Cityhost ist diese Vorbereitung Teil der täglichen Arbeit. Das Unternehmen hat die Zertifizierung nach DSTU ISO/IEC 27001 und DSTU ISO/IEC 27701 erhalten, die sich mit dem Management von Informationssicherheit und dem Schutz personenbezogener Daten befassen. Dahinter stehen konkrete Verfahren: Risikobewertung, Bestimmung der verantwortlichen Personen und Handlungsanweisungen für die Reaktion auf Vorfälle und die Wiederherstellung der Arbeit.
Ein wenig Katastrophengeschichte
- Die Kosten von Fehlern (1950-60er Jahre)
- Der Wendepunkt: Tandem Computers
- RAID: Duplizierung von Festplatten
- Y2K-Katastrophe: Die teuerste Apokalypse, die nicht stattfand
Wer hier jünger ist, erinnert sich vielleicht nicht daran, aber wer älter ist — sollte die Legende über die Katastrophe des Jahrtausends im Gedächtnis haben — das neue Jahrtausend wird kommen, die Timer werden zurückgesetzt, die Technik wird verrückt spielen, die Städte werden in die Apokalypse eintauchen. Geduld, wir kommen gleich darauf zurück, denn es gibt viel zu erzählen, aber erst mal…
Die Kosten von Fehlern (1950-60er Jahre)
Die ersten Computer fielen einfach aus und stoppten damit die Arbeit, die auf ihnen verrichtet wurde. Das war nicht bequem, aber man konnte nichts daran ändern: Etwas ist kaputt gegangen — wir warten, bis es repariert wird. Die Verbreitung von Computern war jedoch geringer, sodass ein Arbeitsausfall unangenehm, aber nicht so kritisch war wie heute. Die kontinuierliche Verfügbarkeit von irgendetwas wurde lange Zeit nicht einmal diskutiert: Man kann auch mal warten.
Natürlich arbeiteten Ingenieure daran, dass Ausfälle seltener wurden. Aber es ging darum, einen Computer zu schaffen, der nicht kaputt geht. Dieser Ansatz dominierte.
Wie immer hing alles von den Finanzen ab.
Erst die Unternehmen, für die einige Minuten Ausfall enorme Kosten verursachten, begannen ernsthaft über Ausfallsicherheit nachzudenken, nicht die Entwickler von Betriebssystemen.
Zuerst — Fluggesellschaften.
Bereits in den 1960er Jahren wurden Ticketbuchungssysteme aus mehreren Computern aufgebaut, die sich gegenseitig ersetzen konnten. Einfach, weil, wenn das System aufhörte, Tickets zu verkaufen, das Geschäft buchstäblich zum Stillstand kam.
Dann zogen Banken nach. Später die Börsen. Noch später die Telekommunikation.
Soweit ich verstehe, ist die Essenz folgende: Je mehr Bereiche computerisiert wurden, wodurch die Arbeit beschleunigt und erleichtert wurde, desto teurer wurde auch der Fehler. Diejenigen, die kontinuierlich arbeiten wollten, stellten einfach mehr Computer auf.
Der Wendepunkt: Tandem Computers
Im Jahr 1974 schlug der HP-Ingenieur James Treybig die Idee vor: nicht zu versuchen, einen Computer zu bauen, der niemals ausfällt.
Stattdessen — einen Computer zu bauen, der nach einem Ausfall weiterarbeiten kann.
HP war an dieser Idee nicht interessiert.
Daraufhin gründete er sein eigenes Unternehmen — Tandem Computers. Bereits 1976 brachte es das NonStop-System auf den Markt, das fast keinen einzigen Ausfallpunkt hatte. Wenn der Prozessor ausfiel, wurde er sofort durch einen anderen ersetzt. Wenn eine Festplatte ausfiel — arbeitete ihre Spiegelkopie. Wenn der Controller ausfiel — gab es einen alternativen Zugang zu den Daten.
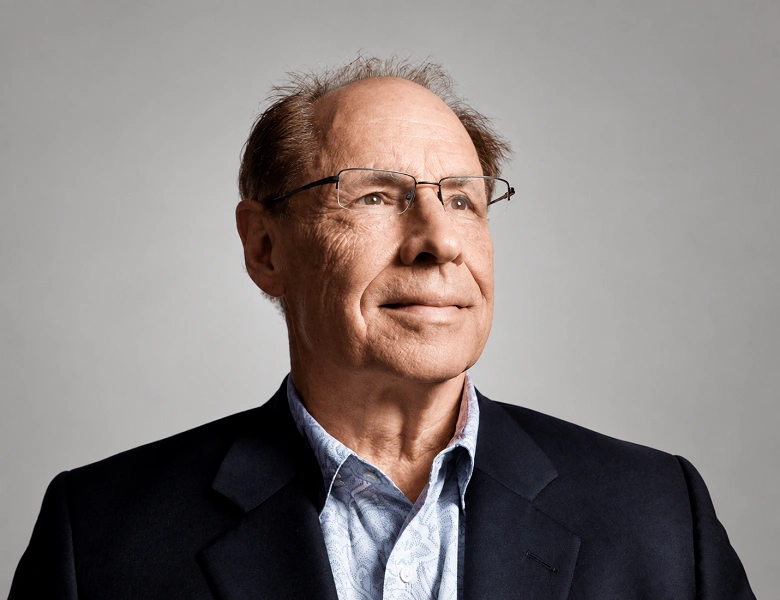
James Treybig
Der erste solcher Computer wurde im Mai 1976 an Citibank ausgeliefert. Danach wurden sie an Börsen und Warenbörsen ausgestattet — darunter die Chicago Mercantile Exchange, die London Stock Exchange, NASDAQ usw.
RAID: Duplizierung von Festplatten
Ende der 1980er Jahre wurde klar: Festplatten sind eines der anfälligsten Teile eines Computers. Sie fielen regelmäßig aus, und zusammen mit ihnen konnten alle Daten verloren gehen.
Deshalb stellten sich die Ingenieure eine unerwartete Frage.
Was wäre, wenn man sich nicht auf eine einzige Festplatte verlassen würde?
Im Jahr 1988 veröffentlichten Forscher der University of California in Berkeley eine Arbeit, die das Konzept von RAID (Redundant Array of Inexpensive Disks) — einem redundanten Array unabhängiger Festplatten — popularisierte. Die Essenz bestand darin, anstelle eines großen Speichers mehrere kleinere zu verwenden, die zusammenarbeiten.
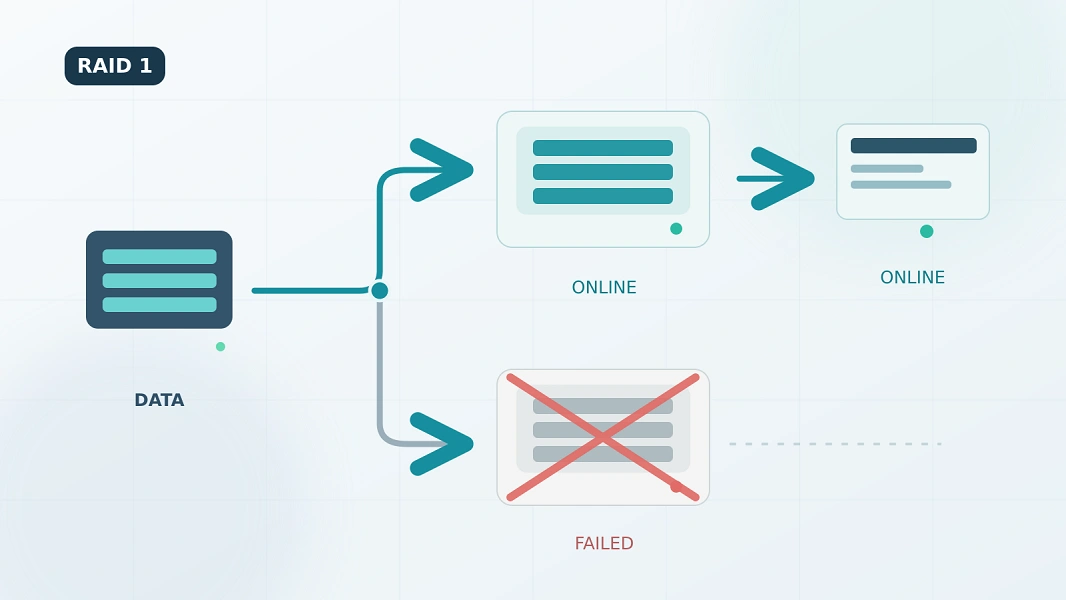
Je nach Konfiguration konnte das Array verschiedene Aufgaben lösen:
- RAID 1 schreibt identische Daten gleichzeitig auf zwei Festplatten. Wenn eine ausfällt, arbeitet die andere ohne Informationsverlust weiter.
- RAID 5 verteilt Daten und Steuerinformationen auf drei oder mehr Festplatten. Wenn eine Festplatte ausfällt, kann das System die verlorenen Daten nach deren Austausch automatisch wiederherstellen.
- RAID 10 kombiniert Spiegelung und Datenverteilung und bietet sowohl hohe Geschwindigkeit als auch Ausfallsicherheit.
Nicht alle RAID-Stufen schützen Informationen gleich gut. Zum Beispiel ist RAID 0 überhaupt dafür geschaffen, die Geschwindigkeit zu erhöhen und hat keine Redundanz: Der Ausfall einer Festplatte bedeutet den Verlust aller Daten. Deshalb bezieht sich der Schutz vor Ausfällen in der Regel auf RAID 1, RAID 5, RAID 6 oder RAID 10.
Und obwohl es heute SSDs, verteilte Dateisysteme und Cloud-Speicher gibt, ist die Idee von RAID nicht verschwunden. Die meisten Server und NAS verwenden sie immer noch in irgendeiner Form.
Aber hier ist, was für uns wichtig ist. Die technische Denkweise hat sich die ganze Zeit von der Suche nach etwas Ausfallsicherem hin zu dem entwickelt, Ausfälle weniger kritisch zu machen. Wir akzeptieren, dass sie passieren werden. Daher: Es ist nicht nötig, eine Festplatte zu erstellen, die niemals ausfällt. Man muss sicherstellen, dass das System nach ihrem Ausfall nicht ebenfalls ausfällt.
Lesen Sie auch: Wie Rechenzentren "ohne Strom" und unter Bedingungen ständiger Angriffe auf das Energiesystem der Ukraine arbeiten
Y2K-Katastrophe: Die teuerste Apokalypse, die nicht stattfand
Lasst uns zur Katastrophe des Jahrtausends oder Y2K zurückkehren. Das ist genau der Fall, in dem eine Katastrophe so gut abgewendet wurde, dass viele dachten, sie hätte nie existiert. Dabei ist es eine der am besten dokumentierten Geschichten im Kampf gegen Katastrophen in der IT.
Also, worin bestand die Besorgnis: Ingenieure in den 1990er Jahren erkannten, dass Millionen von Programmen eine zweistellige Jahreszahl verwendeten. Und das war kein Problem, solange das Jahrtausend andauerte. Die Leute sagten es selbst so: "Im einundachtzigsten Jahr habe ich ein Haus gekauft." Aber um Mitternacht des neuen Jahrtausends sollte der Timer zurückgesetzt werden.
Es war absolut nicht sicher, dass alle Flugzeuge unbedingt abstürzen würden oder die Stromnetze garantiert ausfallen würden. Das Problem war, dass niemand wusste, welche Systeme ausfallen würden und welche Folgen dies haben würde.
Daraufhin begannen Ingenieure auf der ganzen Welt zu arbeiten, als ob eine Katastrophe kurz bevorstand oder bereits eingetreten war.
«Die Aufgabe, die Computersysteme bis zum Jahr 2000 zu reparieren, führte zu einer beispiellosen Mobilisierung von Menschen, Geld und Managementaufmerksamkeit, die in der Geschichte kaum ihresgleichen hat», — schreibt «Washington Post» im Jahr 1998.
Übrigens nennt derselbe Korrespondent auch die Beträge, die für diese Arbeit ausgegeben wurden. Die Federal Reserve, sagt der Journalist Rajiv Chandrasekaran, schätzt, dass Unternehmen allein in den USA mindestens 50 Milliarden Dollar dafür ausgeben werden. Es gibt auch noch größere Zahlen. Die Schätzungen der Kosten zur Bewältigung des Problems des Jahres 2000 variierten, und die endgültige Zahl wurde bis heute ebenfalls nicht ermittelt. Sie übersteigt jedoch 300 Milliarden weltweit, wobei etwa die Hälfte dieser Summe auf die USA entfiel.
Es war ein umfassendes Audit aller Software. Die Unternehmen gingen unterschiedliche Wege:
- Sie fanden alle Stellen im Code, an denen das Datum wichtig war. Ingenieure durchsuchten Millionen von Codezeilen nach Stellen, an denen das Jahr mit zwei Ziffern angegeben wurde. Oft war dies COBOL-Code, der noch in den 1960er und 1970er Jahren geschrieben wurde. Die Dokumentation existierte oft nicht mehr, und die Autoren waren längst entlassen oder in den Ruhestand gegangen. Deshalb wurden viele pensionierte Programmierer vorübergehend zurück ins Arbeitsleben geholt.
- Sie änderten Programme und die Verwendung von Daten in Geldautomaten, medizinischen Geräten, Geräten für Stromnetze, Luftfahrtsystemen usw. Wenn eine Änderung der Datumsangabe nicht möglich war, wurde die Technik ersetzt;
- Sie machten Backups von allem, was sie hatten;
- Sie führten Stresstests durch, indem sie das Datum im System künstlich auf das Jahr null setzten und beobachteten, was ausfiel.
Schließlich feierten viele in der Nacht zum neuen Jahr 2000 nicht, sondern wachten bei der Arbeit.
Und als am 1. Januar 2000 keine ernsthafte Katastrophe eintrat, entschieden viele, dass die Gefahr erfunden war.
Aber in Wirklichkeit war es eine der erfolgreichsten Operationen zur Verhinderung einer technogenen Katastrophe in der Geschichte der Menschheit.
Die Menschheit gab einen Betrag aus, der dem jährlichen BIP eines großen Staates entspricht, nicht um etwas Neues zu schaffen, sondern um sicherzustellen, dass am 1. Januar 2000 alles weiter funktionierte wie am Vortag.
Y2K war nicht das letzte «Datumsproblem». Ähnliche Ausfälle traten auch 2022 auf (wir hatten allerdings nicht die Zeit dafür), als es aufgrund von Überlauf des Zahlenformats Probleme mit Microsoft Exchange und einigen GPS-Navigationsgeräten gab. Dies hing damit zusammen, dass einige Programme das Datum im Format YYMMDDHHMM speicherten und es als 32-Bit-Ganzzahl abspeicherten.
Der nächste bekannte Meilenstein ist das Jahr 2038, und die Industrie bereitet sich schon lange darauf vor. Mehr über die nächsten datumsbezogenen Ausfälle kann man nicht weiter als in der Wikipedia nachlesen.
Diese Geschichte wurde jedoch zu einem enormen Anstoß: Schauen Sie, hier wurde alles verwendet, was wir aus unserem Leben kennen — sowohl Backups als auch das Testen von Systemen auf ihre Widerstandsfähigkeit gegenüber bestimmten Ereignissen.
In jedem Fall ist die Hauptschlussfolgerung, die letztendlich alle zogen: Es geht nicht darum, ob etwas kaputt geht, sondern wann. Und wie du dich darauf vorbereitest.
Drei Hauptprinzipien moderner Infrastruktur
- Backup — wenn Daten verloren gehen
- Redundanz — wenn etwas kaputt geht
- Failover — wenn eine Katastrophe bereits eingetreten ist
Allmählich wurde klar, dass verschiedene Katastrophen unterschiedliche Reaktionen erforderten. So entstanden die drei Prinzipien zum Schutz moderner Infrastruktur.
Backup — wenn Daten verloren gehen
Die Ursachen können vielfältig sein: Festplattenschaden, Administratorfehler, Ransomware, Feuer oder physische Zerstörung des Rechenzentrums.
Deshalb ist modernes Backup keine Kopie auf einer benachbarten Festplatte. Die beste Praxis ist die Regel 3-2-1: drei Kopien der Daten, zwei verschiedene Medien und mindestens eine Kopie an einem anderen Ort. Der Krieg mit Russland hat die Bedeutung dieses Ansatzes nur bestätigt: Für viele Unternehmen wurde ein Backup in einem anderen Land zur absoluten Notwendigkeit.
Redundanz — wenn etwas kaputt geht
Wie kann man sicherstellen, dass das System nicht aufgrund eines Ausfalls eines einzelnen Bauteils aufhört zu funktionieren?
Moderne Dienste duplizieren alles Kritische: Server, Festplatten, Netzwerkpfade, Stromquellen und sogar ganze Rechenzentren. Die Idee ist einfach: Wenn ein Element ausfällt, gibt es ein anderes, das seine Arbeit übernehmen kann.
Failover — wenn eine Katastrophe bereits eingetreten ist
Aber ein Ersatzserver allein löst nichts. Wie wechselt man so schnell zu ihm, dass der Benutzer es nicht einmal bemerkt?
Dafür muss man automatisch auf das Backup-System umschalten, überprüfen, dass es richtig funktioniert, und die Arbeit ohne lange Unterbrechung fortsetzen. Dieses Umschalten wird als Failover bezeichnet. Dank ihm können selbst nach dem Ausfall eines ganzen Rechenzentrums Cloud-Dienste, Banken, Streaming-Dienste usw. weiterhin funktionieren.
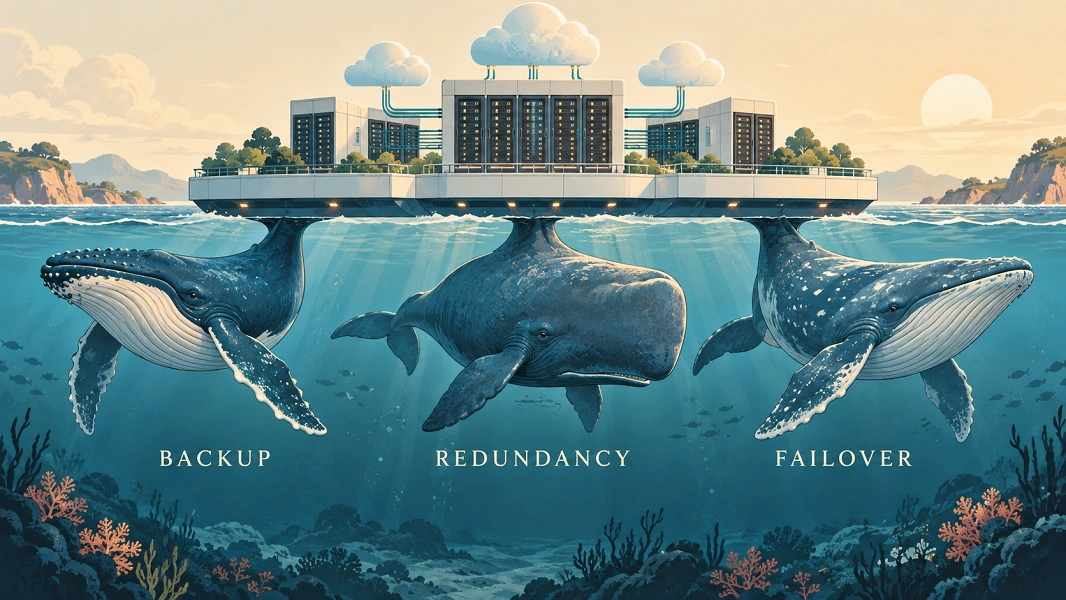
Diese drei Prinzipien ersetzen sich nicht gegenseitig.
- Backup stellt verlorene Daten wieder her.
- Redundanz verhindert, dass das System aufgrund eines einzelnen Ausfalls zusammenbricht.
- Failover sorgt für einen reibungslosen Übergang zu Backup-Ressourcen.
Deshalb verlässt sich die moderne IT zunehmend weniger auf die Zuverlässigkeit einzelner Computer und zunehmend mehr auf die Architektur des gesamten Systems. Ingenieure versuchen nicht mehr, einen Server zu bauen, der niemals ausfällt. Sie bauen eine Infrastruktur, für die ein Ausfall kein Ausnahmefall, sondern ein Szenario ist, das bereits in der Entwurfsphase berücksichtigt wurde.
Lesen Sie auch: 31. März — Tag der Datensicherung. Warum es wichtig ist, Backups nicht zu vergessen und wie man ein Backup seiner Website erstellt (Anleitung)
Geschichten des (Nicht-)Erfolgs
Sogar große Technologieunternehmen, die über Geld, erfahrene Ingenieure und moderne Ausrüstung verfügen, sind nicht vor schwerwiegenden Ausfällen gefeit. Glücklicherweise erzählen einige von ihnen offen von ihren Fehlern und den Wegen, sie zu beheben. Dadurch kann die gesamte Branche aus solchen Vorfällen lernen.
Wie GitLab fast alles verlor (2017)
Im Jahr 2017 löschte ein Administrator von GitLab versehentlich die produktive Datenbank.
Es schien nichts Schlimmes zu sein — es gibt ja Backups. Es stellte sich heraus, dass eine Kopie lange nicht aktualisiert worden war, eine andere beschädigt war, und die dritte ließ sich überhaupt nicht starten; die Replikation funktionierte ebenfalls nicht richtig.
Schließlich rettete eine ganz andere Technologie die Situation — Snapshot, also ein Momentaufnahme des Dateisystems, die auf einem Testserver gespeichert war. Sie wurde etwa sechs Stunden vor dem Vorfall erstellt. Genau von ihr wurde der Dienst über 18 Stunden wiederhergestellt.
Sechs Stunden an Änderungen in der Datenbank gingen unwiderruflich verloren, aber die Datenbank selbst kam wieder in Betrieb.
«Wir haben auch den Wiederherstellungsprozess auf YouTube gestreamt, und zu Spitzenzeiten hatten wir etwa 5000 Zuschauer», schreibt das Unternehmen (eine vollständige Beschreibung der Situation und der Wiederherstellungsmaßnahmen finden Sie hier).
Diese Geschichte zeigt gut, warum Backup in der modernen IT als Prozess und nicht als Datei angesehen wird. Es reicht nicht aus, einmal ein Backup zu erstellen — man muss regelmäßig überprüfen, ob es gestartet werden kann und ob es aktuell ist.
AWS und die Geburt von Chaos Monkey
Im Jahr 2008 erlebte Netflix einen sehr schmerzhaften Ausfall seiner Oracle-Datenbank. Dadurch konnte das Unternehmen drei Tage lang keine DVDs an Kunden versenden. Genau zu diesem Zeitpunkt entschied die Geschäftsführung: Man muss sich von einer einzigen großen Datenbank verabschieden und auf eine cloudbasierte, verteilte Architektur umsteigen. Das Ergebnis war der Umstieg auf AWS (Amazon Web Services), eine riesige Cloud-Plattform, die es ermöglicht, Dienste auf Amazon-Servern zu betreiben.
Dieser Umstieg brachte jedoch ein gewisses Problem mit sich: Wo in einem System Tausende von Servern vorhanden sind, ist die Cloud selbst gegen Ausfälle abgesichert: Andere Server übernehmen die Last des ausgefallenen Servers. Aber reicht das aus, um sicherzustellen, dass der Betrieb Ihres spezifischen Dienstes unterbrechungsfrei ist? Denn die Cloud weiß nicht, wie genau Ihre Arbeit aufgebaut ist — diese Verantwortung liegt bei den Spezialisten von Netflix. Wenn die Architektur des Dienstes von einem kritischen Bauteil abhängt, wird ein Ausfall dennoch zu einem Störfall führen.
Um diese Frage zu beantworten, entwickelte Netflix im Jahr 2010 das Programm Chaos Monkey, das im Rahmen von Tests zufällig einzelne Server, die speziell für ein bestimmtes Unternehmen arbeiten, abschaltet. Wenn nach dem Ausschalten eines oder mehrerer Server etwas kaputt geht oder ausfällt — sind die Funktionen nicht ausreichend dupliziert.
Im Jahr 2012 veröffentlichte das Unternehmen den Code dieses Programms, und viele andere Unternehmen begannen, etwas Ähnliches zu implementieren, das auf ihre Bedürfnisse zugeschnitten war.
Chaos Monkey wurde nicht zu einem Programm, das jeder installiert hat. Stattdessen popularisierte es die Idee des Chaos Engineering. Heute modellieren große Unternehmen regelmäßig Ausfälle, verwenden jedoch oft bereits eigene Werkzeuge oder neue Plattformen zum Testen von Ausfällen.
Wenn man einen Schritt zurücktritt, dann hat Chaos Monkey lediglich automatisiert, was Ingenieure während der Vorbereitung auf Y2K manuell gemacht haben: kontrollierte Ausfälle zu schaffen, um zu überprüfen, ob das System echte Ausfälle überstehen würde.
Wir sehen, dass keiner dieser Ansätze plötzlich entstanden ist; sie haben sich über lange Zeit aus der Praxis entwickelt. Die Realität ist unvollkommen, und deshalb müssen wir alles Wichtige ständig absichern und duplizieren, denn Probleme werden unweigerlich auftreten. Ich denke, diese Philosophie harmoniert perfekt mit unserem alles andere als perfekten Leben während des Krieges.