- Czym jest AI scraping
- Jakie są konsekwencje AI scrapingu dla strony internetowej
- Jak sprawdzić obecność AI scrapingu na stronie internetowej
- Jak zmniejszyć obciążenie spowodowane AI scrapingiem
- Czy można całkowicie zatrzymać szkodliwy AI scraping
Śledzisz projekt internetowy: optymalizujesz bazy danych, kompresujesz obrazy, usuwasz zbędny kod. Liczba odwiedzających rośnie, ale nagle zauważasz, że serwer zaczyna generować błędy lub otrzymujesz wiadomość od dostawcy o przekroczeniu limitów. Choć od razu chcesz obwiniać siebie za niewystarczającą optymalizację, przyczyna może leżeć w niewystarczającej ochronie strony przed AI scrapingiem. Podczas gdy wkładasz maksymalne wysiłki w tworzenie treści i poprawki techniczne, ktoś w ciągu sekundy kradnie Twoje materiały, prowadząc do anormalnych obciążeń. Sprawdziłem to na własnym zasobie internetowym i pokażę, jak znaleźć takie boty i ograniczyć ich działanie bez szkody dla SEO i GEO.
Czym jest AI scraping
AI scraping to automatyczne zbieranie treści stron internetowych przez systemy sztucznej inteligencji. Mogą to robić zarówno duże firmy AI, takie jak OpenAI i Anthropic, które szkolą modele, formułują odpowiedzi w wyszukiwaniu i otwierają strony na zapytania użytkowników, jak i anonimowe scrapery, które maskują się jako zwykła przeglądarka.
AI scraping nie należy mylić z klasycznym parsowaniem stron internetowych, które zbiera konkretne dane, na przykład ceny konkurencji. Zamiast tego boty sztucznej inteligencji przeszukują cały zasób internetowy, w tym stare artykuły i archiwa, przez co obciążają serwer inaczej niż żywi odwiedzający.
Jakie są konsekwencje AI scrapingu dla strony internetowej
Główne konsekwencje AI scrapingu dla strony internetowej to: przeciążenie hostingu, treści bez odwrotnego ruchu oraz kopie Twoich materiałów na obcych zasobach.
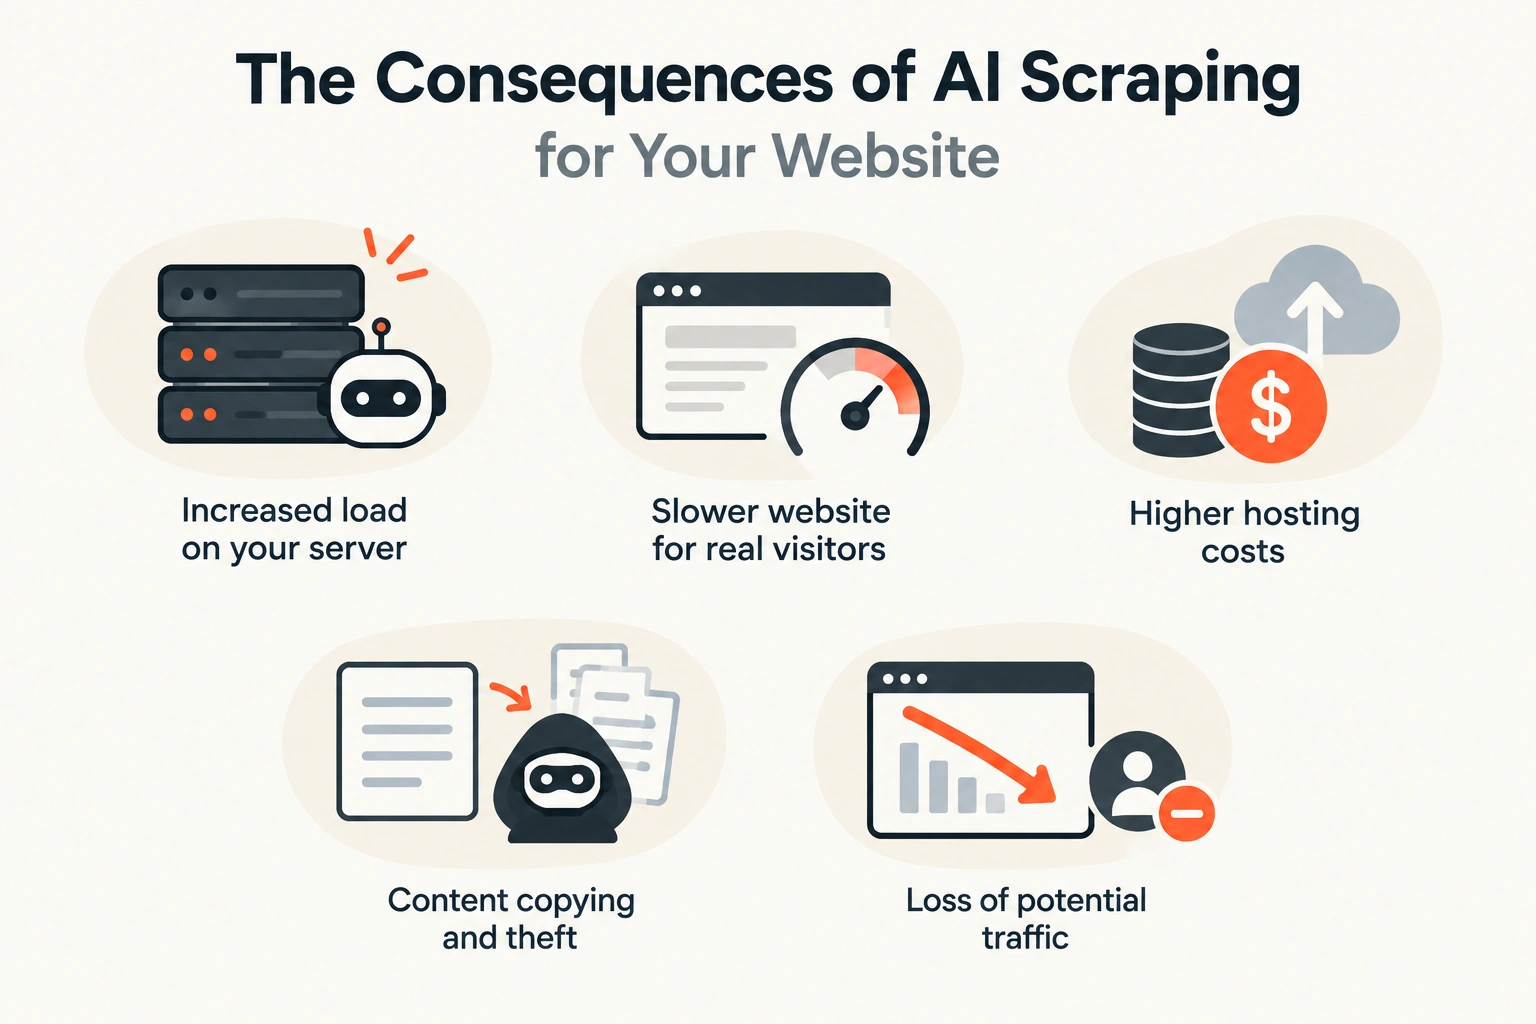
Każda z konsekwencji ma istotne znaczenie dla projektu internetowego każdej wielkości:
- Obciążenie hostingu. Człowiek otwiera kilka stron i czyta każdą przez kilka minut, podczas gdy bot w ciągu godziny może przeglądać tysiące adresów, w tym stare i techniczne, które nie są w pamięci podręcznej. Serwer za każdym razem uruchamia PHP i odwołuje się do bazy danych, przez co strona spowalnia dla żywych odwiedzających lub w ogóle przestaje się otwierać.
- Treści bez odwrotnego ruchu. Systemy AI zabierają teksty znacznie częściej, niż przyciągają czytelników. Z danych TollBit wynika, że europejscy wydawcy otrzymują około 179 wizyt botów AI na jeden przejście żywego użytkownika.
- Kopiowanie treści. Wydanie The Media Copilot przekazało raport TollBit, w którym opisano prawie 40 usług, które sprzedają usługi scrapingu: wiele z nich domyślnie ignoruje robots.txt, a niektóre omijają nawet płatny dostęp. W rezultacie Twoje treści trafiają na obce zasoby internetowe i mogą być tam indeksowane nawet lepiej.
Możesz pomyśleć, że Twojej małej stronie nic nie grozi, ale boty nie szukają konkretnych zasobów internetowych, a przetwarzają listy adresów. Boty wyszukiwarek znajdują strony za pomocą linków i map witryn. Common Crawl co miesiąc przeszukuje ponad 2 miliardy stron dla otwartych archiwów, na których szkolą modele językowe. A scraperzy mają wystarczająco publicznych dzienników certyfikatów SSL, aby znaleźć nową domenę w ciągu kilku minut.
Pod koniec lipca 2026 roku właściciel małej wiki opisał na Medium, jak bot meta-webindexer w ciągu półtorej doby wykonał 230 743 zapytania do strony z 4 814 artykułami. Stare wersje i strony edycji przekształciły kilka tysięcy artykułów w setki tysięcy adresów, 98% zapytań dotyczyło zabronionych w robots.txt stron, a bot zabrał 47% ruchu wyjściowego, a rachunek za chmurę prawie się podwoił.
Jak sprawdzić obecność AI scrapingu na stronie internetowej
Aby sprawdzić AI scraping, porównaj trzy źródła: wykres obciążenia w panelu hostingu, liczbę żywych odwiedzających w Google Analytics i dziennik zapytań do strony. O AI scrapingu można mówić tylko wtedy, gdy szczyty obciążenia zbiegają się w czasie z seriami zapytań konkretnych botów AI.
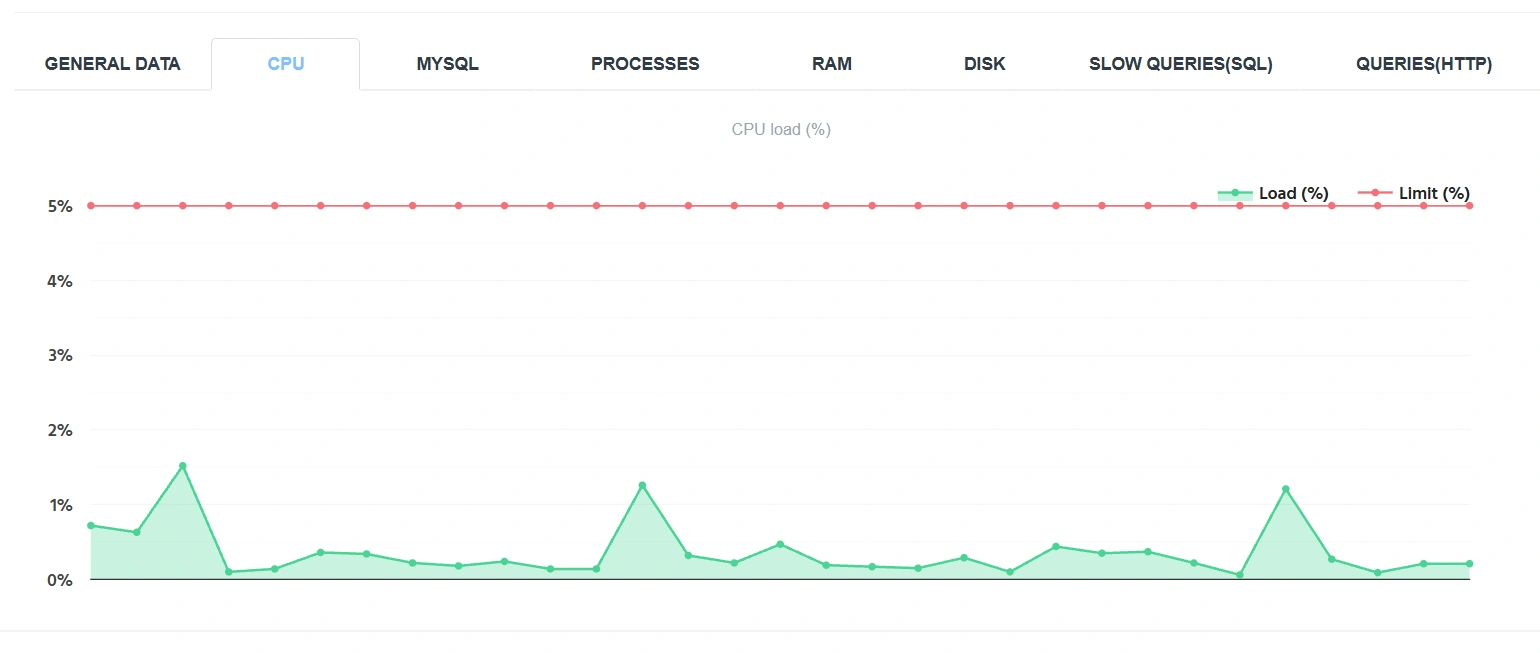
Na zrzucie ekranu wykres obciążenia hostingu jednego z projektów na Cityhost (opublikowane za zgodą właściciela).
Najpierw znajdź szczyty obciążenia:
- Otwórz panel Cityhost → Hosting 2.0 → Zarządzanie → Zasoby.
- Przejdź do zakładki CPU i wybierz najdłuższy dostępny okres.
- Zanotuj datę i godzinę każdego momentu, gdy wykres osiągał limit.
Na mojej stronie w ciągu tygodnia procesor kilka razy osiągał limit 100%, podczas gdy średnie obciążenie wynosiło 40%. Po tym porównaj takie obciążenia z liczbą rzeczywistych odwiedzających na Twoim zasobie internetowym w tym samym okresie:

- Otwórz Google Analytics 4 → Eksploruj → Wolna forma.
- Ustaw okres obejmujący Twoje szczyty.
- Dodaj parametr «Data i czas (RRRRMMDDGG)» do «Wierszy», a wskaźnik «Sesje» — do «Wartości».
- Znajdź w tabeli godziny swoich szczytów.
GA4 automatycznie wyklucza znane boty, a większość innych nie wykonuje JavaScript, więc licznik widzi tylko ludzi. Jeśli obciążenie wzrosło, a sesji nie przybyło, przyczyną są boty lub procesy w tle strony. W ciągu tygodnia GA4 zarejestrował tylko 18 sesji, podczas gdy serwer otrzymał 32 918 zapytań.
Ważne! Sprawdź strefy czasowe: panel hostingu, GA4 oraz dziennik zapytań mogą pokazywać czas w różnych strefach. W moim przypadku różnica między dziennikiem a panelem wynosiła 4 godziny.
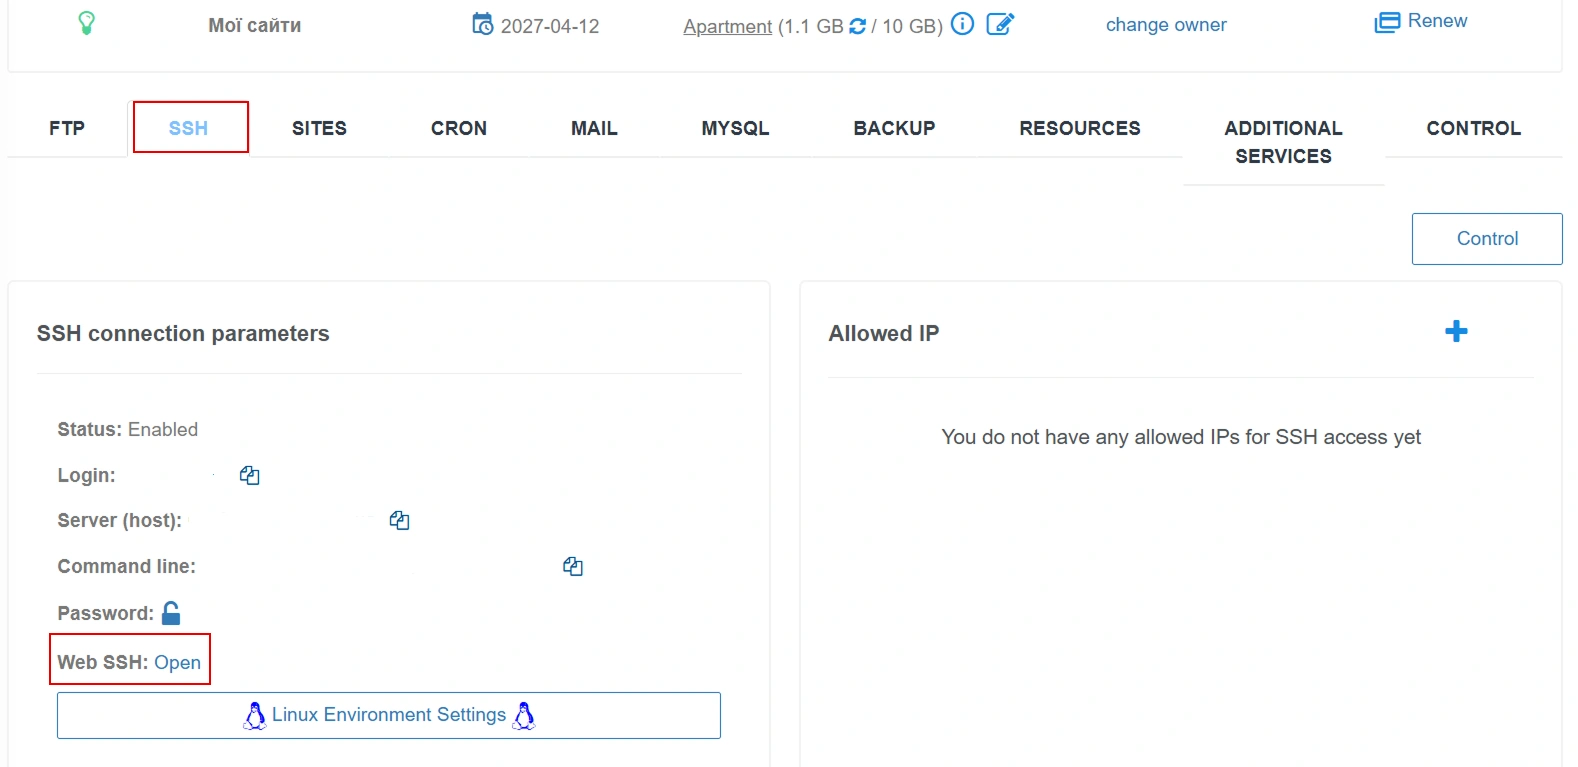
Następnie ustal, kto wykonuje zapytania. W Cityhost dziennik można wygodnie analizować za pomocą narzędzia GoAccess, które uruchamia się przez Hosting → Zarządzanie → SSH → Web SSH → «Web SSH: Otwórz». Instrukcja krok po kroku znajduje się na stronie «Analiza logów dostępu z pomocą GoAccess».

Potrzebujemy sekcji 6 — Systemy operacyjne. Przejdź do niej, naciskając cyfrę 6 na klawiaturze, a następnie naciśnij Enter, aby otworzyć dane. Procent zapytań od botów oraz ich nazwy można zobaczyć w wierszu «Crawlers».
Na zrzucie ekranu GoAccess z 5 października zarejestrowano 3304 zapytania do strony, z czego 596, czyli 18,04%, trafiło do kategorii «Crawlers». Jednak nie można uznać wszystkich tych zapytań za aktywność AI scraperów: w widocznej części listy nie ma nazw GPTBot, ClaudeBot czy PerplexityBot, zamiast tego pokazane są GoogleApp, GoogleMobile, CFNetwork, TwitterBot i facebookexternalhit. Sama kategoria «Crawlers» nie określa, czy zapytanie jest związane ze zbieraniem danych dla sztucznej inteligencji. Szczególnej uwagi wymaga kategoria «Unknown»: na tę kategorię przypada 657 zapytań, czyli 19,88%, ale jej nazwa również nie pozwala ustalić ich pochodzenia. Zatem ten fragment raportu nie potwierdza aktywności AI scraperów i nie wyklucza jej — do wniosków należy sprawdzić pełną listę User-Agent w logach.
Poszukajmy AI botów bezpośrednio w pliku logów przez to samo okno SSH:
- Przełącz klawiaturę na angielską i naciśnij q, aby wyjść z GoAccess. To okno SSH pozostaw otwarte.
- Wklej to polecenie i naciśnij Enter (zastąp MYSITE_NAME swoją domeną, a ch50e2c72b — nazwą swojego konta hostingowego):
awk -F'"' 'tolower($6) ~ /gptbot|oai-searchbot|chatgpt-user|claudebot|claude-searchbot|claude-user|perplexitybot|perplexity-user|meta-externalagent|meta-externalfetcher|meta-webindexer|bytespider|ccbot|amazonbot/ {print $6}' /var/www/ch50e2c72b/logs/MYSITE_NAME.access.log | sort | uniq -c | sort -nr

W komendzie szukaliśmy 14 nazw botów i User-Agent:
- OpenAI: GPTBot, OAI-SearchBot, ChatGPT-User.
- Anthropic: ClaudeBot, Claude-SearchBot, Claude-User.
- Perplexity: PerplexityBot, Perplexity-User.
- Meta: meta-externalagent, meta-externalfetcher, meta-webindexer.
- Inne: Bytespider, CCBot, Amazonbot.
Wyszukiwanie w pełnych User-Agent dało dokładniejszy wynik niż ogólna kategoria «Crawlers» w GoAccess: w sprawdzonym pliku logów znaleziono tylko jedno zapytanie o nazwie OAI-SearchBot — bota wyszukiwarki OpenAI. Innych wymienionych AI botów komenda nie wykryła. Zatem te dane nie świadczą o masowym skanowaniu strony przez AI scraperów, a udział «Crawlers» w raporcie nie można przyrównać do ich aktywności.
Zatem sprawdzenie obecności AI scrapingu jest jednym z najważniejszych etapów. Jeśli masz taką samą sytuację, nie musisz nawet tracić czasu na walkę z AI scrapingiem, wystarczy mądrze optymalizować stronę.
Jak zmniejszyć obciążenie spowodowane AI scrapingiem
Usuń zbędne zadania w tle i aktywuj pamięć podręczną, ogranicz dostęp sumiennych botów przez robots.txt, a tych, którzy nie przestrzegają zasad, spowolnij lub zablokuj na poziomie serwera, Wordfence lub Cloudflare. Całkowita ochrona przed AI scrapingiem jest niemożliwa, ale te metody pomagają przynajmniej zmniejszyć obciążenie na hostingu strony.
- Usuń zbędne zadania w tle
- Włącz pamięć podręczną stron
- Spowolnij zbyt aktywne boty w Wordfence
- Dodaj zasady przeciwko AI scrapingowi w robots.txt
- Zablokuj boty na poziomie serwera
- Włącz zakaz szkolenia w Cloudflare
Usuń zbędne zadania w tle
WordPress uruchamia zadania w tle przez WP-Cron, który domyślnie sprawdza je przy każdym załadowaniu strony. Zatem każde zapytanie bota również może uruchomić kolejny cykl zadań. Na mojej stronie takie zadania generowały 14% wszystkich zapytań: wtyczka Link Whisper co 5 minut sprawdzała uszkodzone linki, a kolejka Action Scheduler uruchamiała się co minutę.

Zalecam:
- Zainstalować wtyczkę WP Crontrol.
- Otworzyć Narzędzia → Wydarzenia Cron.
- Znajdź zadania, które uruchamiają się co minutę lub co kilka minut.
- W kolumnie Akcja przy nazwie funkcji określ wtyczkę, na przykład Wpil należy do Link Whisper.
W rezultacie wybierz te wtyczki i wyłącz je, jeśli ich nie używasz, lub ogranicz ich działanie przez ustawienia każdej konkretnej wtyczki.
Włącz pamięć podręczną stron
Pamięć podręczna stron przechowuje już wygenerowaną stronę jako gotowy plik. Gdy bot lub człowiek ponownie ją żąda, serwer nie uruchamia PHP i nie odwołuje się do bazy danych, a po prostu zwraca plik. Na mojej stronie działa do tego wtyczka LiteSpeed Cache.

W przypadku botów AI pamięć podręczna działa gorzej niż w przypadku ludzi. Ludzie zazwyczaj czytają popularne strony, które już są w pamięci podręcznej, a AI crawlerzy przeszukują całą stronę, w tym stare artykuły, do których nikt dawno nie zaglądał. Jednak skanują wszystkie strony, więc te, które już są w pamięci podręcznej, wciąż pomogą zmniejszyć obciążenie na wirtualnym hostingu lepiej niż całkowity brak pamięci podręcznej na zasobie internetowym.
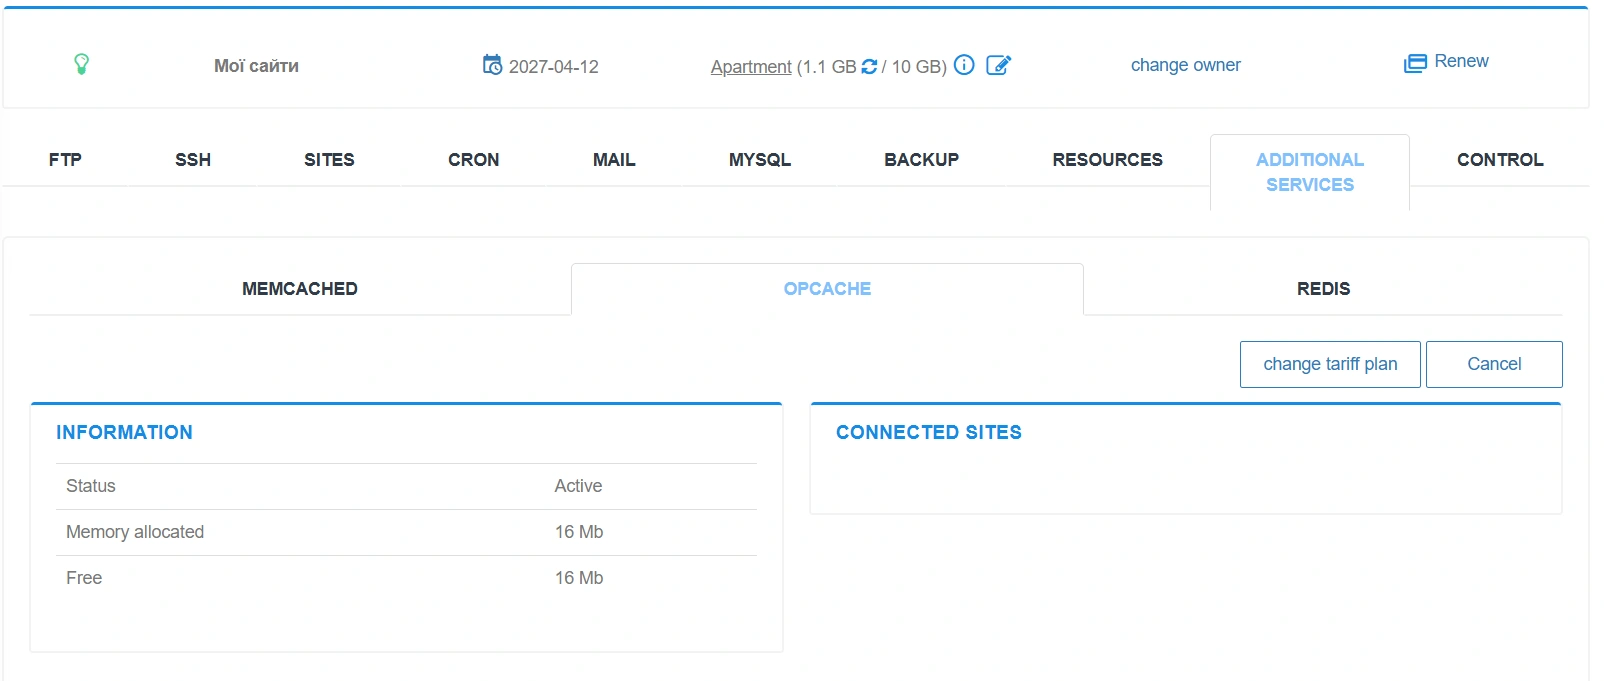
OPcache to inny rodzaj pamięci podręcznej, który przechowuje skompilowany kod PHP, aby serwer nie musiał ponownie odczytywać plików WordPress przy każdym zapytaniu. Przyspiesza generację stron, ale nie zastępuje ich pamięci podręcznej, ponieważ PHP i baza danych działają w ten sam sposób. W Cityhost OPcache jest aktywowane w panelu zarządzania przez Zarządzanie → Dodatkowe usługi → OPcache. Dla stron z częstymi odwołaniami do bazy danych Cityhost oferuje również Memcached i Redis, które przechowują w pamięci wyniki zapytań do bazy.
Przeczytaj także: Usługi pamięci podręcznej dla stron: Memcached, OPCache, Redis
Spowolnij zbyt aktywne boty w Wordfence
Darmowa wersja wtyczki Wordfence, której używam od 2 lat, potrafi ograniczać częstotliwość zapytań:
- Otwórz Wordfence → Wszystkie opcje → Opcje zapory → Ograniczenie częstotliwości.
- Sprawdź, czy włączono Włącz ograniczenie częstotliwości i zaawansowane blokowanie.
- Ustaw 240 zapytań na minutę dla Jeśli zapytania kogokolwiek przekraczają.
- Ustaw 120 dla obu reguł wyświetlania stron i 60 dla obu reguł 404s.
- Dla każdej reguły wybierz Spowolnij to i zapisz zmiany.

To początkowe wartości, które zaleca wsparcie Wordfence. Spowolnienie oznacza, że bot, który przekroczył limit, tymczasowo otrzymuje odpowiedź 503, dopóki nie zmniejszy częstotliwości zapytań. Wyszukiwarki rozumieją taką odpowiedź, dlatego Wordfence zaleca wybierać tę akcję. Limity dla ludzi są również ważne, ponieważ scraperzy, którzy maskują się jako przeglądarka, wpadają w tę kategorię. Upewnij się również, że w Jak powinniśmy traktować crawlerów Google wybrano Zweryfikowani crawlerzy Google nie będą ograniczani.
Ważne! Ograniczenie częstotliwości zatrzymuje nagłe skoki, a nie powolne skanery. Na mojej stronie skaner wykonywał około 10 zapytań na minutę i nie przekroczył żadnego limitu.
Dodaj zasady przeciwko AI scrapingowi w robots.txt
robots.txt to prośba do botów, a nie sztywna zasada: według danych TollBit, w czwartym kwartale 2025 roku 30% zapytań AI scraperów zignorowało jego zakazy. Niemniej jednak, boty wyszukiwarek i szkoleniowe dużych firm zazwyczaj przestrzegają tych zasad. Podzieliłem boty na dwie grupy: tym, które przyciągają czytelników przez AI wyszukiwanie, zezwoliłem na dostęp, a tym, które zbierają treści do szkolenia modeli, zabroniłem.
Możesz edytować robots.txt za pomocą panelu zarządzania hostingiem lub wtyczek SEO, takich jak Rank Math SEO. Do swojego dokumentu, dotyczącego botów, dodałem następujące linie:
User-agent: *

Content-Signal: search=yes, ai-train=no, ai-input=yes

User-agent: OAI-SearchBot

User-agent: ChatGPT-User

User-agent: Claude-SearchBot

User-agent: Claude-User

User-agent: PerplexityBot

User-agent: Applebot

User-agent: DuckAssistBot

User-agent: MistralAI-User

Allow: /

User-agent: GPTBot

User-agent: ClaudeBot

User-agent: Google-Extended

User-agent: Google-CloudVertexBot

User-agent: Applebot-Extended

User-agent: Bytespider

User-agent: CCBot

User-agent: Amazonbot

User-agent: FacebookBot

User-agent: meta-externalagent

Disallow: /
Linia Content-Signal informuje, że treść można wykorzystać do wyszukiwania i odpowiedzi AI, ale nie do szkolenia modeli. Umieść ją w grupie User-agent: * obok istniejących zasad WordPress.
Ważne! Google-Extended nie wpływa na wyszukiwanie Google i AI Overviews, ale jedna zasada obejmuje zarówno szkolenie Gemini, jak i jego odpowiedzi z linkami do źródeł. Zatem, zabraniając go, tracisz również cytaty w Gemini. Jeśli widoczność w Gemini jest dla Ciebie ważniejsza niż ochrona przed szkoleniem, przenieś Google-Extended do grupy Allow.
Zezwolenie w robots.txt nie pomoże, jeśli bota blokuje ochrona serwera. W moich logach dozwolone OAI-SearchBot i PerplexityBot otrzymywały odmowę 403 w około jednej trzeciej zapytań. Zatem po zmianach sprawdź w dzienniku, jaką odpowiedź otrzymują wyszukiwarki AI botów. Jeśli to 403, skontaktuj się z pomocą techniczną hostingu, aby dodać je do wyjątków.
Zablokuj boty na poziomie serwera
Jeśli bot ignoruje robots.txt, zablokuj go na poziomie serwera: wtedy otrzymuje odpowiedź 403 jeszcze przed uruchomieniem WordPress. Najpierw sprawdź dziennik, ponieważ na mojej stronie GPTBot i CCBot już otrzymywały 403 bez żadnych moich zasad.
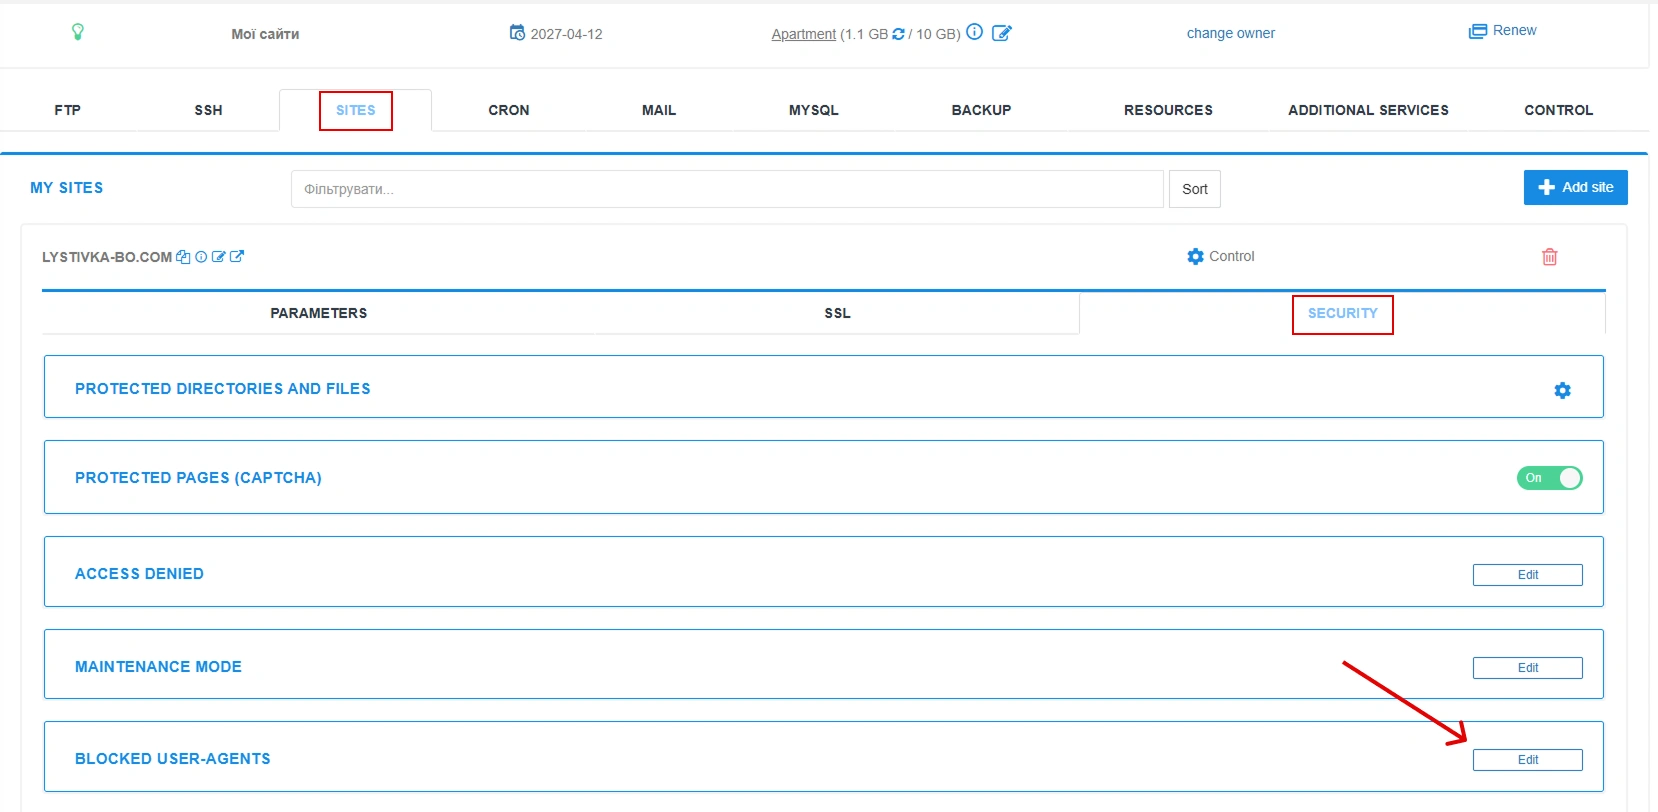
Aby to zrobić:
- Otwórz cp.cityhost.ua → zakładka «Strony».
- Wybierz odpowiednią stronę i przejdź do zakładki «Bezpieczeństwo».
- W sekcji «Zablokowane User-Agents» kliknij «Edytuj».
- Dodaj na końcu listy nazwę bota i zapisz zmiany.
Cityhost już domyślnie blokuje powszechne szkodliwe boty. Możesz sprawdzić, czy blokada zadziałała, używając polecenia curl -I "https://twoja-strona.com" -A "CCBot" w Web SSH: w odpowiedzi powinien być kod 403.
Ważne! Nie dodawaj do listy Googlebot, bingbot i wyszukiwarki AI botów, w przeciwnym razie strona straci ruch z wyszukiwania i widoczność w odpowiedziach AI. A scraperzy, którzy maskują się jako przeglądarka, nie zostaną zatrzymani przez blokadę User-Agent.
Przeczytaj także: Złe boty: jak szkodzą stronie i jak je zablokować
Włącz zakaz szkolenia w Cloudflare
Cloudflare zatrzymuje boty jeszcze przed dotarciem do hostingu, a potrzebne narzędzia są dostępne na darmowym planie, z którego korzystam już od 1,5 roku:

- Dodaj stronę do Cloudflare i zmień serwery NS domeny na te, które on poda.
- Otwórz swoją domenę → Bezpieczeństwo → Ustawienia.
- W filtrze grup wybierz Ruch botów.
- Kliknij Skonfiguruj zasady botów AI.
- Dla Szkolenia wybierz Zablokuj, a dla Wyszukiwania i Agenta pozostaw Zezwól (nie blokuj).
- Kliknij Zapisz.
Opcja Zablokuj blokuje boty szkoleniowe Amazon, Anthropic, Meta i OpenAI, a Googlebot, Applebot i Bingbot nadal indeksują stronę dla wyszukiwania.

Przełącznik Włącz synchronizację preferencji botów dodaje zasady Cloudflare na początku robots.txt. Jeśli już zabroniłeś Google-Extended i Applebot-Extended w swoim własnym robots.txt, jak opisano powyżej, pozostaw go wyłączonym, aby zasady się nie dublowały.
Ważne! Od 15 września 2026 roku opcje Blokuj i Blokuj na stronach z reklamami dla Szkolenia zatrzymują również Googlebot, Bingbot i Applebot. Dlatego do zakazu szkolenia wybieraj właśnie Zablokuj.
Czy można całkowicie zatrzymać szkodliwy AI scraping
Nie. Część botów maskuje się jako zwykli odwiedzający, i na małej stronie rozpoznać wszystkich jest niemożliwe. Cloudflare opisał, jak Perplexity po zablokowaniu przechodził na User-Agent przeglądarki Chrome i zmieniał adresy IP, a odkrycie tego było możliwe tylko po badaniach na danych z milionów stron. Niemniej jednak opisane metody wciąż pozwalają pozbyć się większej części botów.
Tylko nie spiesz się z działaniami. Mój test pokazał, że strach przed AI scrapingiem często jest większy niż rzeczywista szkoda: boty AI wygenerowały tylko 3,2% zapytań, a procesor obciążały skanery luk oraz zadania w tle WordPressa. Dlatego nie blokuj wszystkich na raz. Najpierw znajdź, co dokładnie obciąża Twój hosting, i rozwiązuj konkretnie ten problem, a AI boty ograniczaj tylko wtedy, gdy rzeczywiście je znajdziesz w logach. I sprawdzaj dziennik zapytań przynajmniej raz w miesiącu, aby na czas zauważyć nowych botów.