Wszyscy możemy przypomnieć sobie kilka dużych awarii, które nas dotknęły. Dobrze pokazywały, jak kruche jest współczesne życie. Jak niewygodne staje się, gdy system energetyczny zostaje wyłączony przez ostrzały: to prawdopodobnie dotknęło absolutnie każdego — zimno, brak internetu, wind, a czasami — wody. Ale były też mniejsze katastrofy, które zauważyliśmy i które zostały pokonane w ciągu kilku dni.
Na przykład, wszyscy pamiętamy, jak 12 grudnia 2023 roku przestał działać Kyivstar. Nie można było zadzwonić, skorzystać z internetu mobilnego, a razem z siecią operatora tymczasowo przestały działać także niektóre bankomaty, terminale POS i inne usługi, które od niej zależały. Przywracanie trwało kilka dni. Jako mama, która odprowadza dziecko do przedszkola i ciągle pozostaje w kontakcie na wypadek, gdyby zachorowało lub zdarzyła się inna sytuacja awaryjna, pamiętam, jak niewygodnie było biegać po mieście bez zasięgu.
A były też katastrofy, które nie miały miejsca.
Na przykład, w kwietniu 2022 roku rosyjscy hakerzy próbowali wyłączyć ukraiński system energetyczny. Atak udało się zatrzymać dosłownie w ostatniej chwili. Większość Ukraińców nawet się o tym nie dowiedziała.
Współczesny sektor IT walczy z awariami zanim one nastąpią. A najlepszy wynik pracy, w ten sposób — to wtedy, gdy nawet nie zdajemy sobie sprawy z pracy, ponieważ systemy są tak dobrze zduplikowane, że naprawa przebiega niezauważenie.
Wiąże się to z tym, że inżynierowie zazwyczaj planują nie sukces, a porażkę. Jeśli zawiedzie centrum danych — strona działa; wideo nie zatrzymuje się, gdy przerywamy kabel; pliki nie znikają z uszkodzonego dysku serwera.
Ta logika odnosi się również do zwykłej strony internetowej. Wybierając hosting lub serwer wirtualny, warto zwrócić uwagę nie tylko na szybkość i pojemność pamięci, ale także na to, co stanie się z projektem w przypadku awarii. Jakie kopie zapasowe są dostępne, gdzie są przechowywane, kto i jak będzie przywracał działanie — te pytania lepiej zadać jeszcze przed pierwszą awarią.
Dla nas w Cityhost taka przygotowanie — to część codziennej pracy. Firma przeszła certyfikację według DSTU ISO/IEC 27001 i DSTU ISO/IEC 27701, które dotyczą zarządzania bezpieczeństwem informacji i ochrony danych osobowych. Za tym stoją konkretne procedury: ocena ryzyka, określenie odpowiedzialnych osób i porządek działań w odpowiedzi na incydenty oraz przywracanie działania.
Trochę historii katastrof
- Koszt błędów (lata 1950-60)
- Przełomowy moment: Tandem Computers
- RAID: duplikacja dysków twardych
- Katastrofa Y2K: najdroższy apokalipsa, która nie miała miejsca
Kto jest młodszy, nie pamięta tego, ale kto starszy — powinien pamiętać legendę o katastrofie roku zero — nadejdzie nowe tysiąclecie, timery się zresetują, technika oszaleje, miasta pogrążą się w apokalipsie. Cierpliwości, teraz do tego wrócimy, bo jest o czym opowiadać, a tymczasem…
Koszt błędów (lata 1950-60)
Pierwsze komputery po prostu się psuły i razem z nimi zatrzymywała się praca, którą na nich wykonywano. To nie było wygodne, ale nic nie da się zrobić: coś się spaliło — czekamy, aż naprawią. Jednak rozpowszechnienie komputerów było mniejsze, więc przerwa w pracy była niewygodna, ale nie tak krytyczna, jak teraz. Ciągła dostępność czegokolwiek przez długi czas nawet nie była omawiana: można to znieść.
Bez wątpienia inżynierowie pracowali nad tym, aby awarie zdarzały się rzadziej. Ale chodziło o stworzenie komputera, który się nie psuje. Dominował właśnie ten kierunek.
Jak zawsze, wszystko sprowadzało się do finansów.
Pierwszymi, którzy poważnie zaczęli myśleć o niezawodności, nie byli twórcy systemów operacyjnych, ale ludzie, dla których kilka minut przestoju kosztowało ogromne pieniądze.
Na początku — linie lotnicze.
Już w połowie lat 60. systemy rezerwacji biletów budowano z kilku komputerów, które mogły się wzajemnie zastępować. Po prostu dlatego, że jeśli system przestawał sprzedawać bilety, biznes dosłownie stawał.
Później dołączyły banki. Później — giełdy papierów wartościowych. Jeszcze później — telekomunikacja.
O ile rozumiem, istota jest taka: im więcej dziedzin zautomatyzowano, przyspieszając i ułatwiając pracę, tym więcej kosztowała również pomyłka. Ci, którzy chcieli pracować bez przerwy, po prostu stawiali więcej komputerów.
Przełomowy moment: Tandem Computers
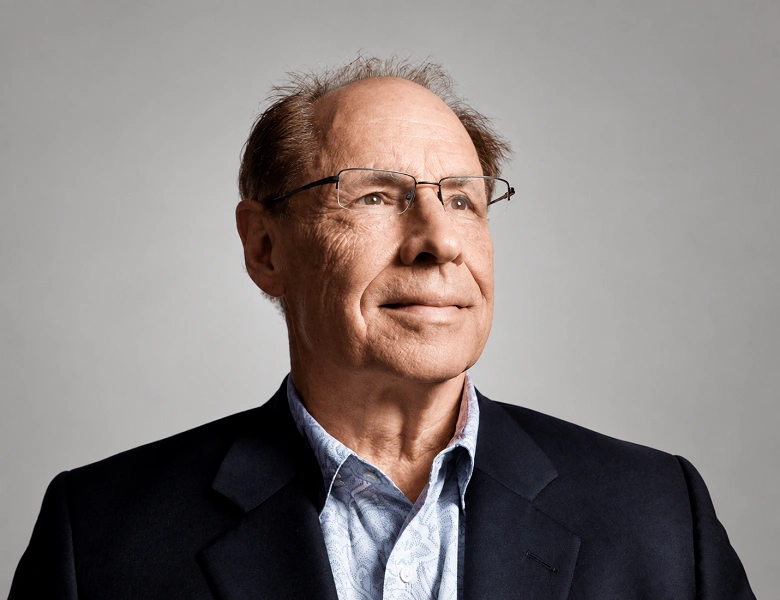
W 1974 roku inżynier HP James Treybing zaproponował pomysł: nie próbować stworzyć komputera, który nigdy się nie psuje.
Zamiast tego — stworzyć komputer, który może nadal działać po awarii.
HP ta idea nie zainteresowała.
Wtedy założył własną firmę — Tandem Computers. Już w 1976 roku wydała system NonStop, w którym prawie nie istniała pojedyncza punkt awarii. Jeśli procesor zawodził, natychmiast był zastępowany przez inny. Jeśli zawodził dysk — działała jego lustrzana kopia. Jeśli psuł się kontroler — istniała alternatywna droga dostępu do danych.
James Treybing
Pierwszy taki komputer dostarczono do Citibank w maju 1976 roku. Następnie wyposażono w nie giełdy papierów wartościowych i towarowych — w tym Chicago Mercantile Exchange, London Stock Exchange, NASDAQ itd.
RAID: duplikacja dysków twardych
Pod koniec lat 80. stało się oczywiste: dyski twarde — jedna z najbardziej wrażliwych części komputera. Regularnie się psuły, a razem z nimi mogły zniknąć wszystkie dane.
Dlatego inżynierowie postawili sobie zaskakujące pytanie.
A co, jeśli przestaniemy polegać na jednym dysku?
W 1988 roku badacze z Uniwersytetu Kalifornijskiego w Berkeley opublikowali pracę, która spopularyzowała koncepcję RAID (Redundant Array of Inexpensive Disks) — nadmiarowego zestawu niezależnych dysków. Jej istota polegała na tym, aby zamiast jednego dużego nośnika używać kilku mniejszych, które współpracują.
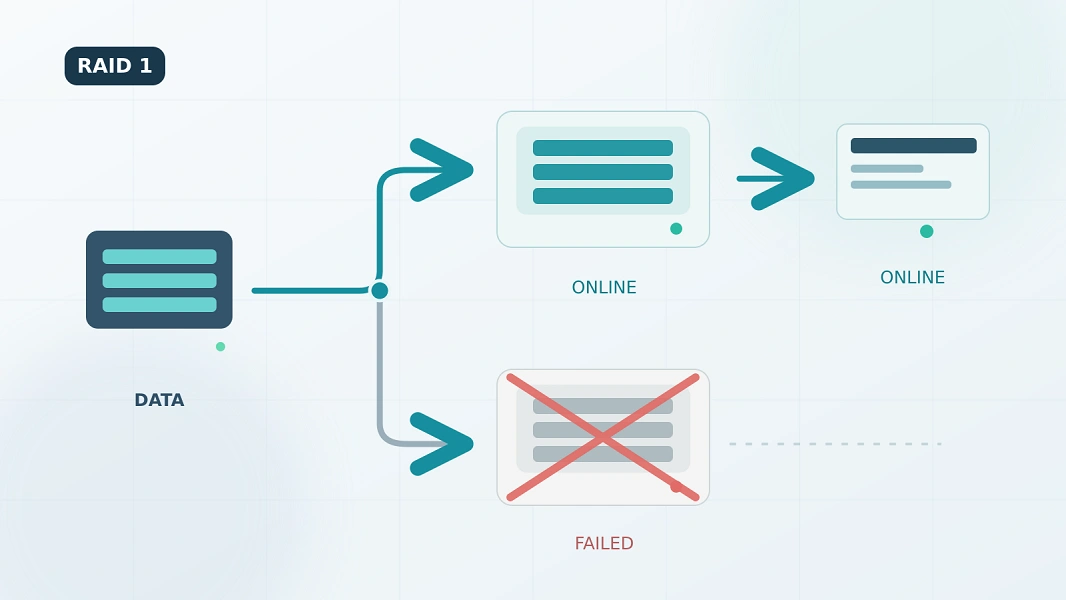
W zależności od konfiguracji macierz mogła rozwiązywać różne zadania:
- RAID 1 zapisuje te same dane jednocześnie na dwóch dyskach. Jeśli jeden zawiedzie, drugi nadal działa bez utraty informacji.
- RAID 5 rozdziela dane i informacje kontrolne między trzema lub więcej dyskami. Jeśli jeden dysk ulegnie awarii, system może automatycznie przywrócić utracone dane po jego wymianie.
- RAID 10 łączy lustrzane odbicie i rozdział danych, zapewniając zarówno wysoką prędkość, jak i odporność na awarie.
Nie wszystkie poziomy RAID w równym stopniu chronią informacje. Na przykład, RAID 0 został stworzony wyłącznie w celu zwiększenia prędkości i nie ma rezerwacji: awaria jednego dysku oznacza utratę wszystkich danych. Dlatego, gdy mówi się o ochronie przed awariami, zazwyczaj ma się na myśli RAID 1, RAID 5, RAID 6 lub RAID 10.
I chociaż dzisiaj istnieją SSD, rozproszone systemy plików i chmurowe magazyny, sama idea RAID nigdzie nie zniknęła. Większość serwerów i NAS nadal ją wykorzystuje w takim czy innym kształcie.
Ale oto, co jest dla nas ważne. Cały czas myślenie techniczne przesuwało się od poszukiwania czegoś niezawodnego do tego, aby uczynić awarie mniej krytycznymi. Przyjmujemy, że będą się zdarzać. Więc: nie trzeba tworzyć dysku, który nigdy się nie zepsuje. Trzeba zrobić tak, aby system po jego awarii również się nie zepsuł.
Przeczytaj także: Jak centra danych działają "bez światła" i w warunkach ciągłych ostrzałów systemu energetycznego Ukrainy
Katastrofa Y2K: najdroższy apokalipsa, która nie miała miejsca
Wracając do katastrofy roku zero lub Y2K. To jest właśnie ten przypadek, kiedy katastrofę odwrócono tak dobrze, że wielu postanowiło, że w ogóle nie istniała. A tymczasem to jedna z najlepiej udokumentowanych historii walki z katastrofą w IT.
Otóż, w czym tkwiło zaniepokojenie: inżynierowie w latach 90. zrozumieli, że miliony programów używają dwu-cyfrowego zapisu roku. I to nie stanowiło problemu, dopóki trwało tysiąclecie. Ludzie sami tak mówili: "w osiemdziesiątym pierwszym kupiłem dom". Ale o północy nowego roku dwutysięcznego timer miał się zresetować.
Absolutnie nie jest pewne, że wszystkie samoloty musiałyby spaść ani że sieci elektryczne na pewno by się zatrzymały. Problem polegał na tym, że nikt nie wiedział, które systemy zawiodą i jakie będą tego konsekwencje.
Wtedy na całym świecie inżynierowie zaczęli pracować tak, jakby katastrofa miała się zdarzyć w każdej chwili lub już miała miejsce.
«Zadanie naprawy systemów komputerowych do 2000 roku spowodowało bezprecedensową mobilizację ludzi, pieniędzy i uwagi zarządzającej, której prawie nie ma analogii w historii», — pisze «Washington Post» w 1998 roku.
Przy okazji, ten sam korespondent podaje również kwoty wydane na tę pracę. Federalny rezerwat, mówi dziennikarz Rajiv Chandrasekaran, przewiduje, że firmy wydadzą na to co najmniej 50 miliardów dolarów tylko w USA. Są tam również bardziej gigantyczne liczby. Prognozy wydatków na rozwiązanie problemu roku 2000 różniły się, a ostatecznej kwoty nikt do tej pory nie obliczył. Jednak przekracza ona 300 miliardów na cały świat, przy czym gdzieś połowa tej kwoty przypadła na USA.
To był ogromny audyt całego oprogramowania. Firmy podążały różnymi drogami:
- znajdowały wszystkie miejsca, gdzie w kodzie ważna była data. Inżynierowie przeglądali miliony linii kodu w poszukiwaniu miejsc, gdzie rok zapisywano dwiema cyframi. Często był to kod COBOL, napisany jeszcze w latach 60-70. Dokumentacja często już nie istniała, a autorzy dawno odeszli lub przeszli na emeryturę. Dlatego wielu emerytowanych programistów tymczasowo wróciło do pracy.
- zmieniali programy i użycie daty w bankomatach, sprzęcie medycznym, urządzeniach dla sieci elektrycznych, systemach lotniczych itd. Jeśli zmiana zapisu daty była niemożliwa, sprzęt wymieniano;
- robili kopie zapasowe wszystkiego, co mieli;
- przeprowadzali testy obciążeniowe, sztucznie przestawiając datę w systemie na rok zero i sprawdzając, co się psuje.
Wreszcie, w nocy na Nowy rok wiele osób nie świętowało, a czuwało w pracy.
Gdy 1 stycznia 2000 roku nie doszło do poważnej katastrofy, wielu postanowiło, że niebezpieczeństwo było wymyślone.
Jednak w rzeczywistości była to jedna z najbardziej udanych operacji zapobiegania katastrofie technologicznej w historii ludzkości.
Ludzkość wydała sumę porównywalną z rocznym PKB dużego państwa, nie na stworzenie czegoś nowego, ale na to, aby 1 stycznia 2000 roku wszystko nadal działało jak wczoraj.
Y2K nie była ostatnim «problemem dat». Podobne awarie powtarzały się także w 2022 roku (nam było, co prawda, nie do tego), gdy z powodu przepełnienia formatu liczbowego pojawiły się problemy w Microsoft Exchange i niektórych nawigacjach GPS. Było to związane z tym, że niektóre programy zapisywały datę w formacie YYMMDDHHMM i przechowywały ją jako 32-bitową liczbę całkowitą.
Następnym znanym terminem jest rok 2038, a przemysł już od dawna się do niego przygotowuje. Szczegółowe informacje na temat kolejnych awarii związanych z datami można znaleźć nie dalej niż w Wikipedii.
Jednak ta historia stała się ogromnym impulsem do przodu: zobaczcie, wykorzystywano tu wszystko, co znamy z naszego życia — i kopie zapasowe, i testowanie systemu na odporność przed tym czy innym zdarzeniem.
W każdym razie główny wniosek, który ostatecznie wszyscy wyciągnęli: nie chodzi o to, czy coś się zepsuje, chodzi o to, kiedy. I o to, jak się do tego przygotujesz.
Trzy główne zasady nowoczesnej infrastruktury
- Backup — jeśli dane zostały utracone
- Redundancja — jeśli coś się zepsuje
- Failover — jeśli katastrofa już miała miejsce
Stopniowo stało się jasne, że różne katastrofy wymagają różnych reakcji. Tak uformowały się trzy zasady ochrony nowoczesnej infrastruktury.
Backup — jeśli dane zostały utracone
Przyczyną może być cokolwiek: awaria dysku, błąd administratora, wirus szyfrujący, pożar czy fizyczne zniszczenie centrum danych.
Dlatego nowoczesny backup — to nie kopia na sąsiednim dysku. Najlepszą praktyką jest zasada 3-2-1: trzy kopie danych, dwa różne nośniki i przynajmniej jedna kopia — w innym miejscu. Wojna z Rosją tylko potwierdziła znaczenie tego podejścia: dla wielu firm kopia zapasowa w innym kraju stała się po prostu koniecznością.
Redundancja — jeśli coś się zepsuje
Jak sprawić, aby system nie przestał działać z powodu awarii jednego komponentu?
Nowoczesne usługi duplikują wszystko, co krytyczne: serwery, dyski, trasy sieciowe, źródła zasilania, a nawet całe centra danych. Idea jest prosta: jeśli jeden element zawiedzie, jest inny, który może przejąć jego pracę.
Failover — jeśli katastrofa już miała miejsce
Jednak zapasowy serwer sam w sobie nic nie rozwiązuje. Jak przełączyć się na niego tak szybko, aby użytkownik tego nawet nie zauważył?
W tym celu trzeba automatycznie przełączyć się na zapasowy system, sprawdzić, czy działa poprawnie, i kontynuować pracę bez długiej przerwy. Takie przełączanie nazywa się failover. Dzięki niemu nawet po awarii całego centrum danych mogą nadal działać usługi chmurowe, banki, serwisy streamingowe itd.
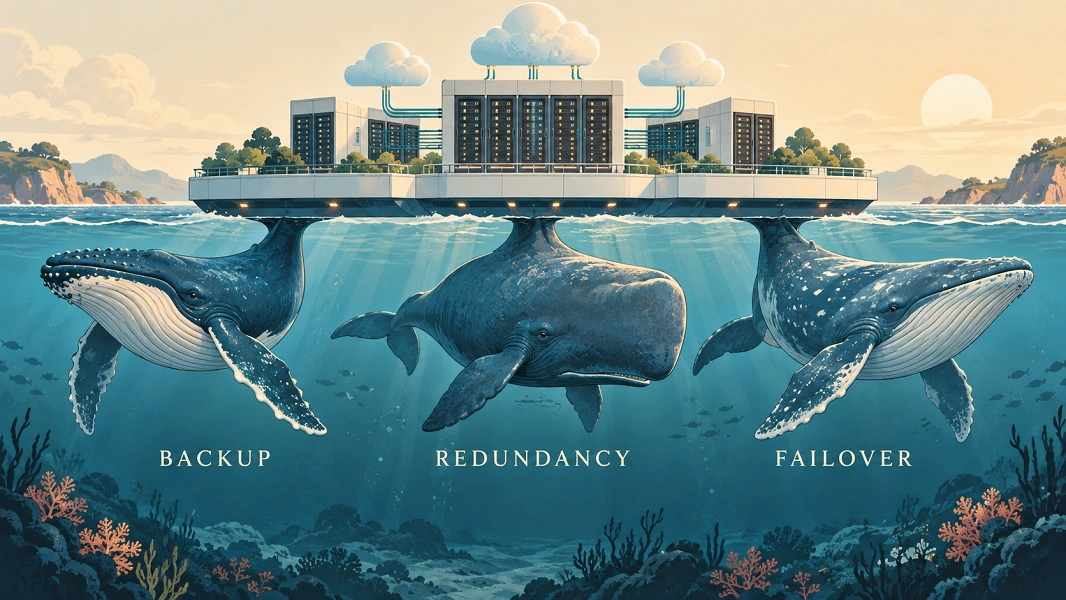
Te trzy zasady nie zastępują się nawzajem.
- Backup przywraca utracone dane.
- Redundancja nie pozwala systemowi upaść przez jedną awarię.
- Failover zapewnia płynne przejście na zapasowe zasoby.
Dlatego nowoczesne IT coraz mniej polega na niezawodności pojedynczych komputerów, a coraz więcej — na architekturze całego systemu. Inżynierowie już nie starają się zbudować serwera, który nigdy się nie zepsuje. Budują infrastrukturę, dla której awaria — to nie wyjątek, a scenariusz przewidziany już na etapie projektowania.
Przeczytaj także: 31 marca — dzień tworzenia kopii zapasowych. Dlaczego ważne jest, aby nie zapominać o backupach i jak zrobić kopię zapasową swojej strony (instrukcja)
Historie (nie) sukcesu
Nawet duże firmy technologiczne, które mają pieniądze, doświadczonych inżynierów i nowoczesny sprzęt, nie są ubezpieczone przed poważnymi awariami. Na szczęście niektóre z nich otwarcie opowiadają o swoich błędach i sposobach ich naprawy. Dzięki temu cała branża może uczyć się na takich awariach.
Jak GitLab prawie stracił wszystko (2017)
W 2017 roku administrator GitLab przypadkowo usunął działającą bazę danych.
Wydawało się, że nic strasznego — są przecież kopie zapasowe. Okazało się, że jedna kopia od dawna nie była aktualizowana, inna była uszkodzona, trzecia w ogóle się nie uruchamiała; replikacja również działała nieprawidłowo.
Ostatecznie sytuację uratowała zupełnie inna technologia — snapshot, czyli migawka systemu plików, która była przechowywana na serwerze testowym. Została zrobiona około sześciu godzin przed awarią. To z niej przez ponad 18 godzin przywracano działanie usługi.
Sześć godzin zmian w bazie danych zostało utraconych bezpowrotnie, ale sama baza wróciła do działania.
«Transmitowaliśmy również procedurę przywracania na YouTube, w szczytowym momencie transmisji oglądało ją około 5 tysięcy widzów», piszą w firmie (pełny opis sytuacji i działań związanych z przywracaniem można znaleźć tutaj).
Ta historia dobrze pokazuje, dlaczego tworzenie kopii zapasowych w nowoczesnym IT postrzegane jest jako proces, a nie jako plik. Nie wystarczy raz stworzyć backupu — trzeba regularnie sprawdzać, czy można go uruchomić i czy jest aktualny.
AWS i narodziny Chaos Monkey
W 2008 roku Netflix doświadczył bardzo bolesnej awarii własnej bazy danych Oracle. Z tego powodu firma przez trzy dni nie mogła wysyłać DVD do klientów. Właśnie wtedy kierownictwo postanowiło: trzeba zrezygnować z jednej dużej bazy i przejść na chmurową, rozproszoną architekturę. Efektem był przejazd na AWS (Amazon Web Services), ogromną chmurową platformę, która pozwala uruchamiać usługi na serwerach Amazon.
Jednak ten przejazd stworzył pewien problem: tam, gdzie w systemie są tysiące serwerów, sama chmura jest ubezpieczona przed awarią: inne serwery przejmują obciążenie tego, który się zepsuł. Ale czy to wystarczy, aby praca konkretnej usługi była nieprzerwana? Przecież chmura nie wie, jak zbudowana jest twoja praca — ta odpowiedzialność spoczywa na specjalistach Netflix. Jeśli architektura usługi zależy od jednego krytycznego komponentu, awaria i tak doprowadzi do zakłóceń.
Aby odpowiedzieć na to pytanie, Netflix w 2010 roku stworzył program Chaos Monkey, który w ramach testowania losowo wyłącza poszczególne serwery działające dla konkretnej firmy. Jeśli po wyłączeniu jednego lub kilku serwerów coś się zepsuło lub upadło — funkcje nie są wystarczająco zduplikowane.
W 2012 roku firma udostępniła kod tego programu, a wiele innych firm zaczęło wprowadzać coś podobnego, dostosowanego do siebie.
Chaos Monkey nie stał się programem, który zainstalowano wszyscy. Zamiast tego spopularyzował samą ideę chaos engineering. Dziś duże firmy regularnie modelują awarie, ale często korzystają już z własnych narzędzi lub nowych platform do testowania awarii.
Jeśli cofnąć się o krok, to Chaos Monkey tylko zautomatyzował to, co podczas przygotowań do Y2K inżynierowie robili ręcznie: tworzyli kontrolowane awarie, aby sprawdzić, czy system przetrwa prawdziwą.
Widzimy, że żaden z tych podejść nie powstał nagle, wszystkie formowały się przez długi czas z praktyki. Rzeczywistość jest niedoskonała, dlatego musimy ciągle zabezpieczać i duplikować wszystko, co ważne, ponieważ problemy na pewno się pojawią. Wydaje mi się, że ta filozofia idealnie harmonizuje z naszym nieidealnym życiem w czasie wojny.