- Czym jest hosting współdzielony i dlaczego wymagał nowych rozwiązań
- Co zmieniły CMS w działaniu stron internetowych
- Izolacja sąsiadów na wspólnym serwerze
- Co to daje dla optymalizacji
Wczesny internet był dość prosty: strony składały się ze statycznych stron HTML, które serwer wysyłał na żądanie przeglądarki, i to wszystko. Z czasem zaczęły się rozwijać, wzbogacając się o wideo, bazy danych, duże katalogi produktów i kolekcje plików. Pojawiły się konta osobiste, koszyki, płatności online i inne funkcje, które wymagały coraz więcej zasobów. Razem z stronami musiał rozwijać się również hosting: stawać się potężniejszym i znajdować nowe sposoby przetwarzania żądań. To była swoista wyścig — gdy tylko w internecie pojawiało się coś nowego, serwery musiały nauczyć się z tym pracować.
W 1998 roku typowa strona mogła składać się z kilku plików HTML. Po 10 latach, w 2008 roku, jedna strona WordPress mogła już uruchamiać setki funkcji PHP i dziesiątki zapytań SQL. W 2018 roku do tego dołączyły skomplikowane frameworki JavaScript, liczne API, usługi zewnętrzne, wideo i spersonalizowane treści. A do 2028 roku strony prawdopodobnie jeszcze aktywniej będą wykorzystywać AI, generując część treści w czasie rzeczywistym i dostosowując interfejs do konkretnego użytkownika. To ogromna ewolucja, która trwa.
Czym jest hosting współdzielony i dlaczego wymagał nowych rozwiązań
Hosting współdzielony — jeden z najpopularniejszych rodzajów hostingu. Na nim hostuje się wiele rzeczy — od osobistych blogów po strony małych sklepów. Zazwyczaj hostingi tego typu od razu oferują możliwość zainstalowania lub uzyskania wstępnie zainstalowanej CMS. Na pewno, jeśli szukałeś hostingu, widziałeś oferty w stylu „hosting WordPress”, „Sklepy internetowe na kreatorze stron” itp.
Na początku historii sieci, aby umieścić stronę, trzeba było mieć własny serwer lub wynająć go w całości. Hosting współdzielony rozwiązywał problem wysokich kosztów takich serwerów. Jeśli chcesz sprzedawać, powiedzmy, ręcznie robiony papier w małym sklepiku, tysiące dolarów na osobisty serwer po prostu nie są w twoim zasięgu. Ale oprócz tego — nigdy nie wykorzystasz wszystkich jego możliwości. Zbyt drogo i nieefektywnie. Zatem nowy rodzaj hostingu pozwalał umieszczać na jednym serwerze setki stron zamiast jednej, znacznie obniżając koszty.
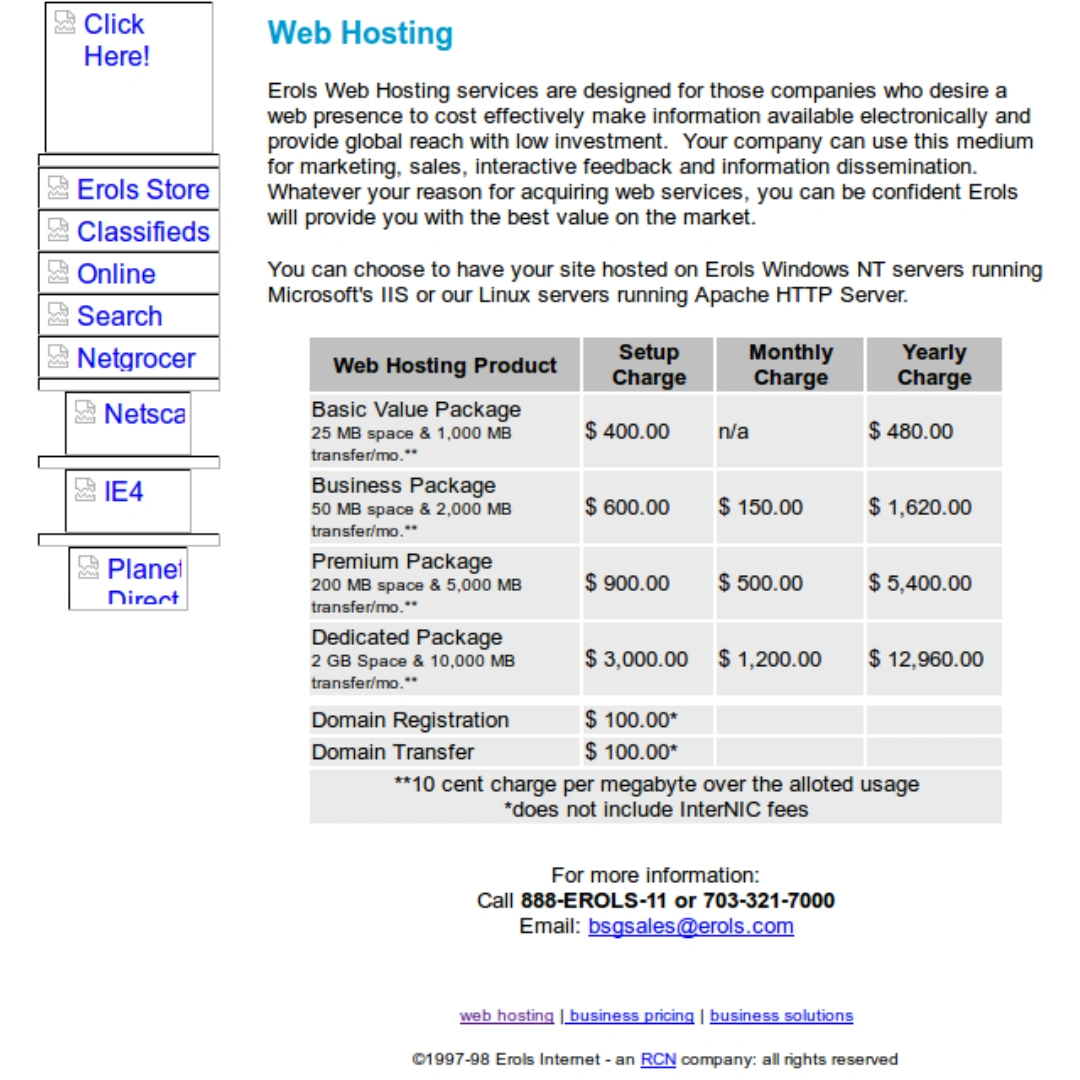
Taryfy Erols Internet na hosting w latach 1997–1998. Nawet podstawowy pakiet z 25 MB przestrzeni dyskowej kosztował 400 USD za podłączenie i jeszcze 480 USD rocznie. Takie ceny wydają się kosmiczne, ale wtedy hosting biznesowy był skomplikowaną i drogą usługą, skierowaną przede wszystkim do firm. Źródło: JeremyPerson.com.
Istota jest prosta: zamiast przydzielać osobny komputer dla każdego klienta, jeden serwer dzieli swoje zasoby między wiele stron. Wszystkie korzystają z tego samego procesora, pamięci RAM, dysku i połączenia sieciowego. Dlaczego to stało się możliwe? Odpowiedzi są dwie: charakterystyka obciążenia i sama idea wirtualnego hostingu.
Większość stron przez znaczną część czasu generuje niewielkie obciążenie. Odwiedzający przychodzą nieregularnie, a szczytowe okresy w różnych projektach zazwyczaj się nie pokrywają. Dlatego zasoby jednego dużego serwera można rozdzielić między wiele stron: podczas gdy jedna wykorzystuje więcej mocy, inne mogą jej po prostu nie potrzebować.
Drugie, co uczyniło taki model możliwym, to mechanizm wirtualnego hostingu.
Ważną rolę w rozwoju hostingu współdzielonego odegrał standard HTTP/1.1, opublikowany w 1997 roku. Uczynił on obowiązkowym nagłówek Host, dzięki któremu przeglądarka informuje serwer, do którego dokładnie domeny się zwraca. Dzięki temu jeden serwer, a nawet jeden adres IP, mogły obsługiwać wiele różnych stron. To nie tylko obniżyło koszty hostingu, ale także pomogło spowolnić wyczerpywanie adresów IPv4.
Serwer WWW określa, do której domeny zwrócił się użytkownik, i wysyła odpowiednią stronę. Dla właściciela wygląda to tak, jakby miał osobistą przestrzeń dla swojego projektu, chociaż procesor, pamięć i dysk są w rzeczywistości dzielone między dziesiątki lub setki klientów.
To właśnie ten model uczynił internet naprawdę dostępnym. Uruchomienie strony nie oznaczało już kupowania własnego serwera — wystarczyło wynająć małą część już istniejącego.
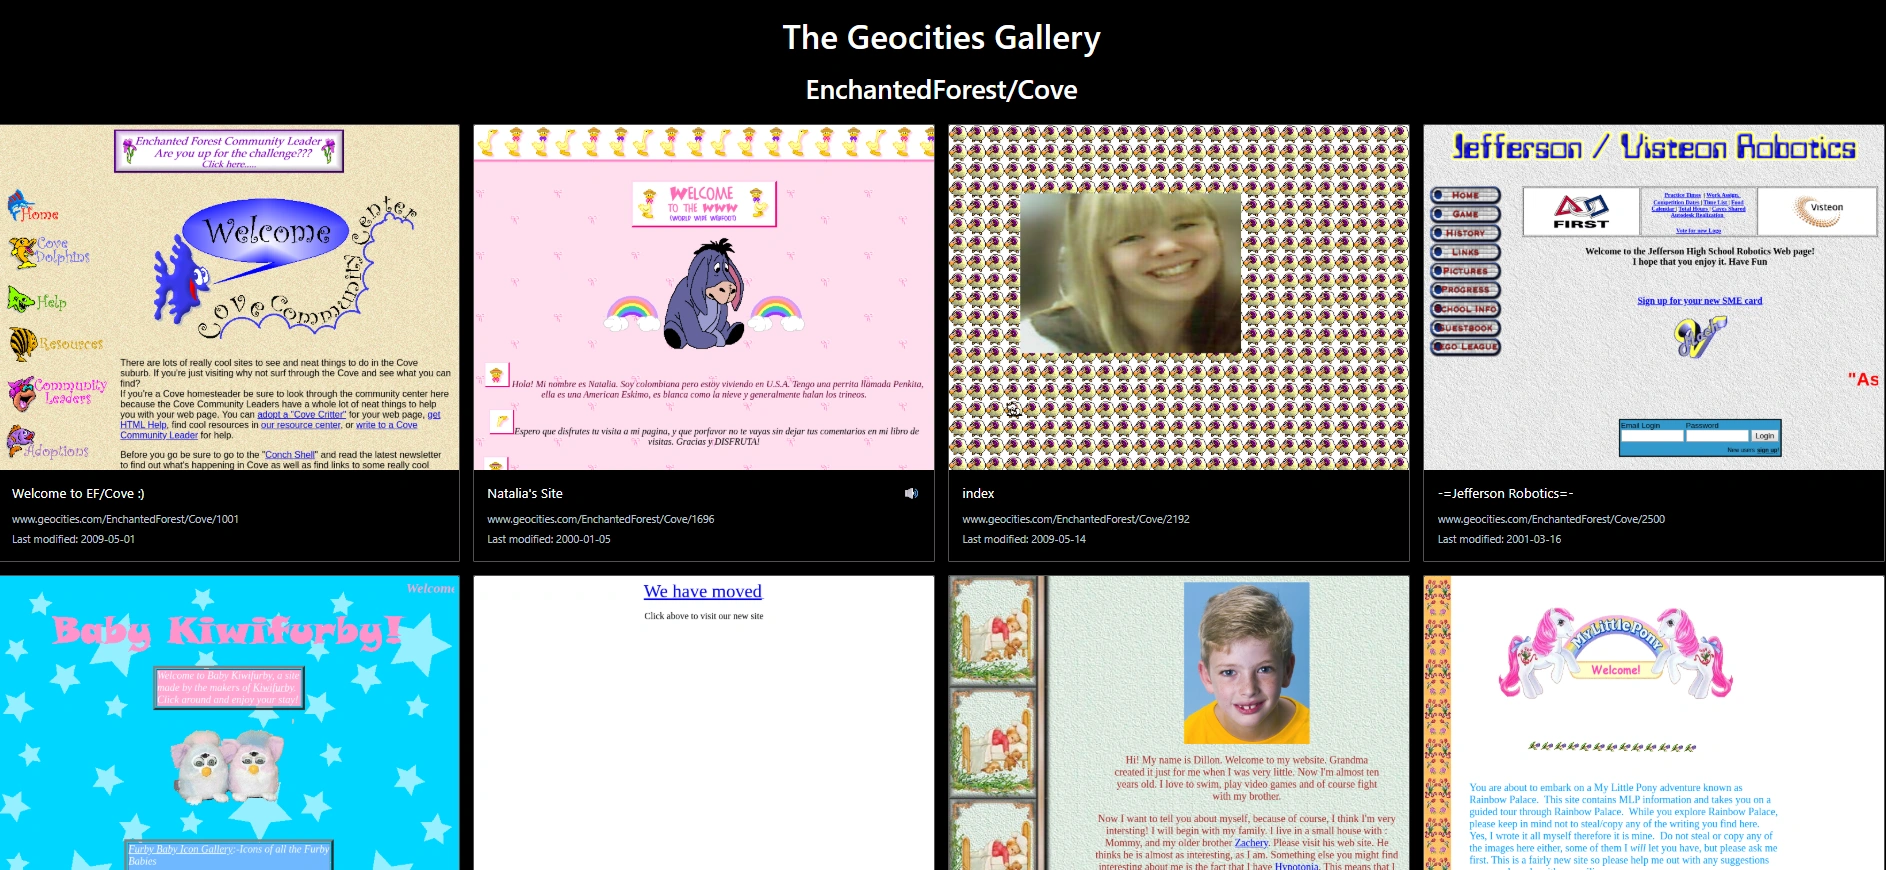
Osobną stroną w historii dostępnego internetu był GeoCities — jedna z najbardziej znanych usług bezpłatnego hostingu lat 90. Użytkownicy otrzymywali 1 MB przestrzeni dyskowej i mogli stworzyć własną stronę bez kupowania serwera i głębokiej wiedzy technicznej. Strony były podzielone na tematyczne „dzielnice”: na przykład strony o technologii osiedlały się w SiliconValley, a o filmach i celebrytach — w Hollywood. W rezultacie GeoCities przekształcił się w ogromne cyfrowe miasto z jaskrawymi tłem, animowanymi GIF-ami, licznikami odwiedzin i napisami „W budowie”. Więcej o tej legendarnej usłudze i internecie lat 90. opowiadamy w naszym wideo.
Ale taki system działa dobrze tylko wtedy, gdy wszyscy „sąsiedzi” zużywają mniej więcej tę samą ilość zasobów. Jednak wraz z rozpowszechnieniem dynamicznych stron i CMS utrzymanie tej równowagi stawało się coraz trudniejsze. Jeden projekt mógł generować setki procesów PHP, ciągle odwoływać się do bazy danych lub nagle zwiększać obciążenie podczas skoku odwiedzalności.
Co zmieniły CMS w działaniu stron internetowych
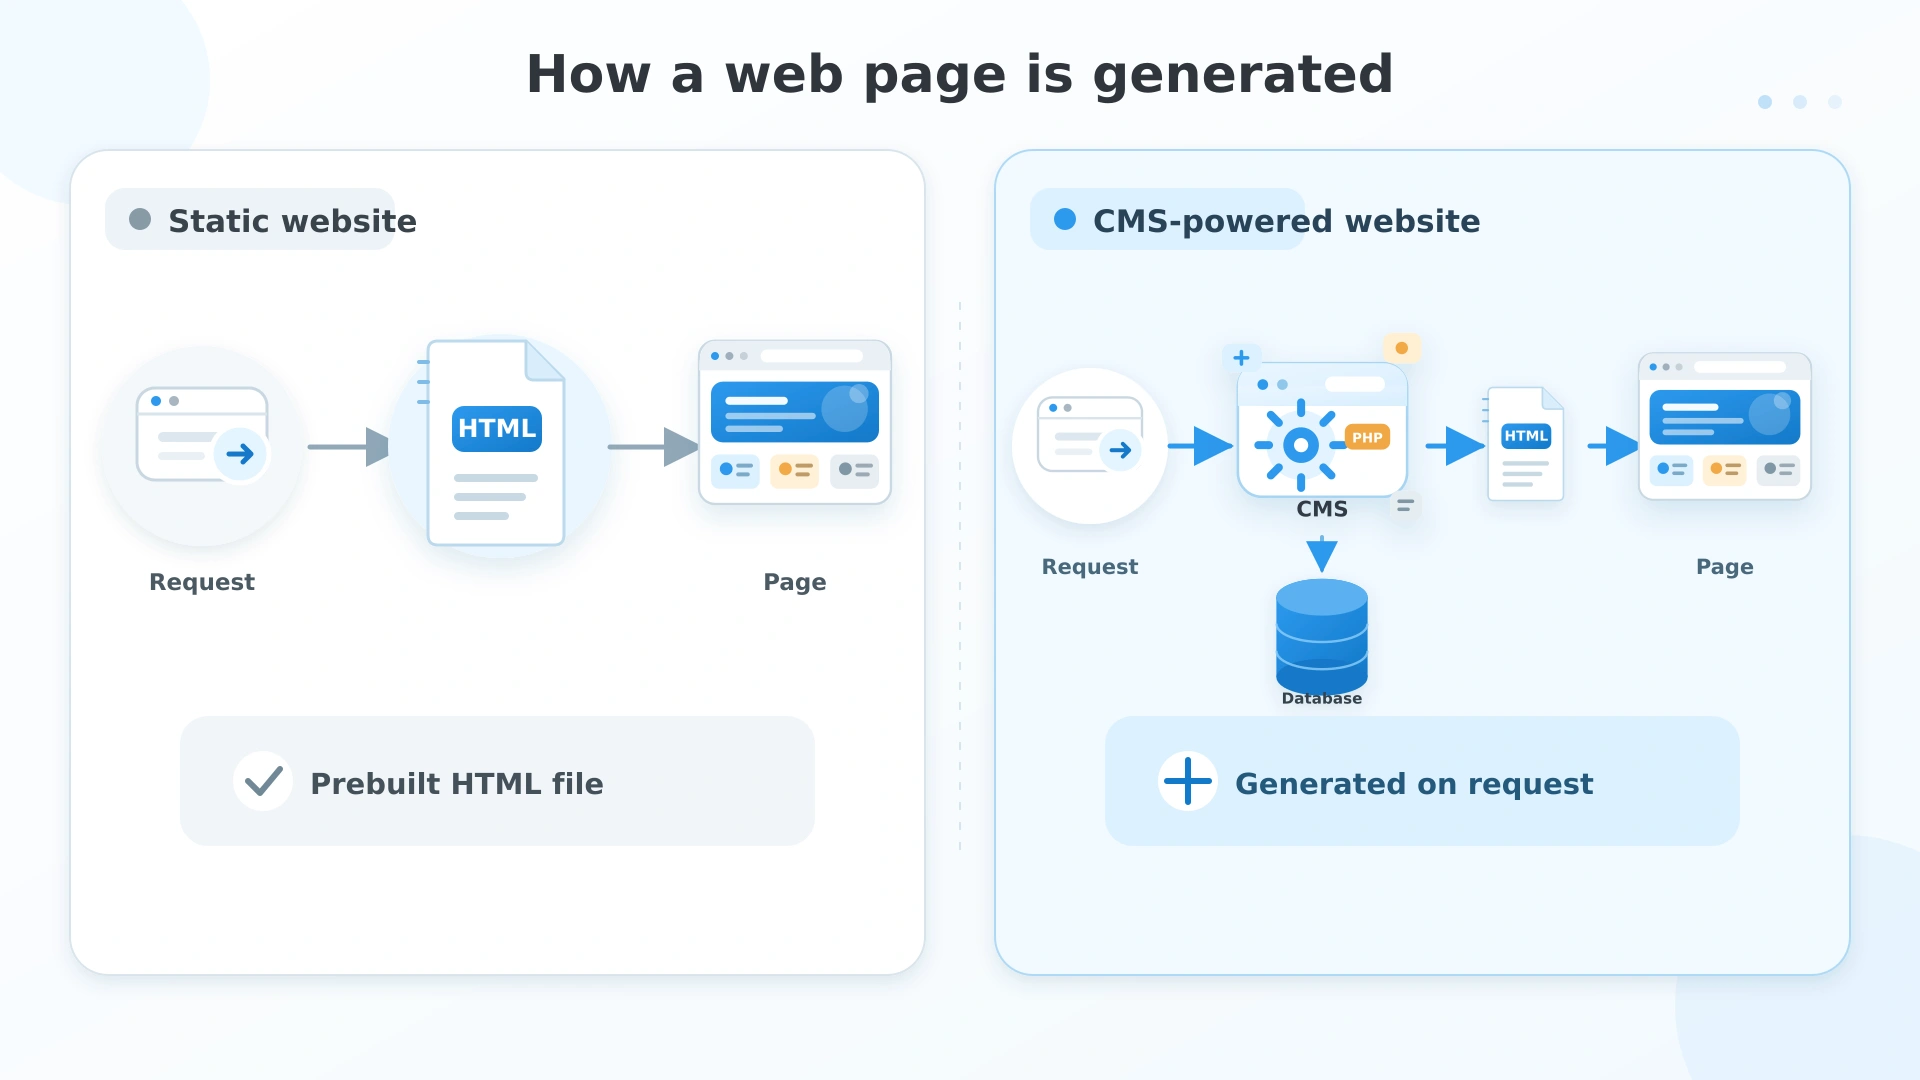
CMS stały się jednym z najpopularniejszych rodzajów dynamicznych stron. W przeciwieństwie do statycznych stron, generują HTML za pomocą kodu programowego, danych z bazy i zainstalowanych modułów.
Jako użytkownicy, nie obchodzi nas, co dzieje się wewnątrz strony. Zauważamy problemy, ale nigdy nie myślimy o wewnętrznych procesach, jeśli strona nie zawiesza się w trakcie zakupu biletu na pociąg.
Początkowo większość stron składała się z zwykłych plików HTML. Jeśli trzeba było zmienić tekst na stronie, administrator otwierał plik i edytował go ręcznie.
CMS (Content Management System, system zarządzania treścią) zmieniły ten model. Zamiast zestawu gotowych stron, strona stała się programem. Teksty, struktura stron i ustawienia zaczęły być przechowywane w bazie danych, a obrazy i inne pliki — w magazynie strony. Podczas każdego żądania CMS zbierała z tych komponentów gotową stronę.
Dla właściciela strony oznaczało to, że nie trzeba już znać HTML, aby opublikować wiadomość lub napisać artykuł. Można sobie poradzić samodzielnie lub zatrudnić menedżera treści, który nie jest projektantem stron, kosztuje mniej, szybko daje radę. Dla serwera zaś każde wyświetlenie strony nagle stało się znacznie bardziej skomplikowaną pracą: pamiętamy, że serwer nie tylko oddawał stronę, wyciągając ją z biblioteki, ale ją przetwarzał. Zatem trzeba było doskonalić te procesy, aby oszczędzać zasoby i upraszczać ścieżkę.
OPcache: oszczędność czasu procesora
Kiedy użytkownik otwierał stronę WordPress, za każdym razem wykonywał tę samą pracę. To wyglądało tak: PHP czytało dziesiątki plików z dysku, przekształcało je w wewnętrzną reprezentację (bajtowy kod) i dopiero potem uruchamiało.
To znaczy, że nawet jeśli kod strony w ogóle się nie zmieniał, serwer wykonywał tę samą przygotowawczą pracę przy każdym żądaniu. OPcache zaczął przechowywać już skompilowany kod w pamięci. W przyszłości PHP mogło od razu wykonać program, omijając kilka kosztownych etapów.
Faktycznie serwer przestał za każdym razem „przeczytać książkę” przed tym, jak odpowiedzieć użytkownikowi.
Pierwszy cache opcode dla PHP stworzyła firma Zend Technologies jeszcze w 1998 roku. Nazywał się Zend Optimizer (później Zend Optimizer+). W 2013 roku współzałożyciel firmy i jeden z współautorów nowoczesnego PHP Zeev Suraski zaproponował otwarcie kodu źródłowego Optimizer+ i włączenie go do PHP 5.5. Po integracji komponent otrzymał nazwę OPcache.
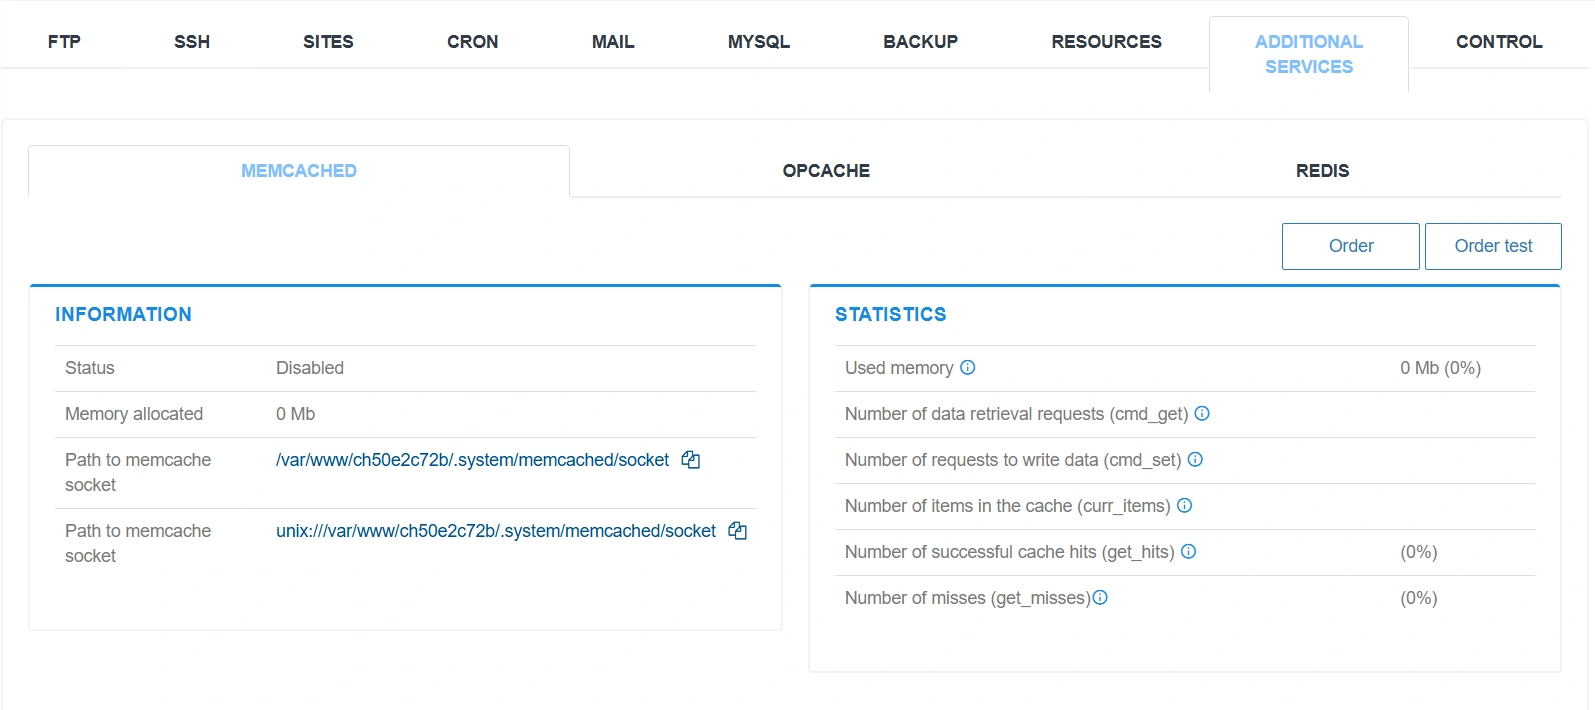
Przy okazji, w panelu zarządzania hostingiem Cityhost.ua istnieje możliwość włączenia narzędzi cachowania w sekcji Strony — Usługi dodatkowe.
Przeczytaj także: Usługi cachowania dla stron: Memcached, OPCache, Redis
Cache strony: oszczędność przy regeneracji stron
Dla większości odwiedzających strona główna jest taka sama. Ale znów przypominamy sobie, że CMS może za każdym razem na nowo pytać bazę danych, pytać wtyczki, generować HTML na nowo.
Więc następnym pytaniem było, po co tworzyć od podstaw stronę, która prawie zawsze jest taka sama. Również trzeba ją było cache'ować. Po pierwszym żądaniu serwer przechowywał już gotowy HTML, a CMS w ogóle nie musiała się uruchamiać, aby pokazać tę stronę. Mniejsze obciążenie na procesorze i bazach danych, błyskawiczna odpowiedź strony — wszyscy szczęśliwi.
Ale co, jeśli strona się zmieniła? Na przykład w blogu pojawił się nowy artykuł, który trzeba pokazać w bloku wiadomości na stronie głównej — i to już nie ta sama strona. I tutaj optymalizacja musiała za każdym razem znajdować odpowiedź na pytanie, w którym momencie można w ogóle nie uruchamiać CMS, a kiedy stronę główną trzeba jeszcze raz przetworzyć.
Tak powstał mem o najtrudniejszych rzeczach w programowaniu. Cytat należy do Phila Carltona (pracownika Xerox PARC): „W programowaniu są tylko dwie naprawdę trudne rzeczy: unieważnienie cache i nazewnictwo”.
Cache obiektów: oszczędność na zapytaniach do bazy danych
Dynamika strony ciągle odwołuje się do bazy danych, co by się nie działo, od komentarza po zmianę kategorii produktu. I odwołania znów są kosztowne, ale często bezsensowne, ponieważ jakaś strona może być ta sama przez miesiące.
Cache obiektów daje możliwość zapamiętywania wyników pojedynczych zapytań do baz danych. Jeśli aplikacja już wie, jakie kategorie istnieją lub jakie ma wartość konkretne ustawienie, nie ma sensu za każdym razem niepokoić MySQL.
Można tu przywołać jeszcze jedną ciekawą historię — Memcached, system, który stworzono nie dla CMS, ale który rozwiązywał podobny problem. Został wymyślony dla Livejournal, strony z ogromną ilością osobistych dzienników, na której kiedyś siedzieli wszyscy nasi znajomi. Mieli problem: baza danych przestała radzić sobie z obciążeniem, chociaż ogromna liczba zapytań zwracała te same wyniki. Inżynier Brad Fitzpatrick z kolegami napisał małą usługę, która po prostu zapamiętywała odpowiedzi w pamięci operacyjnej. To rozwiązanie szybko okazało się uniwersalne i zaczęto je stosować praktycznie we wszystkich dużych projektach PHP.
Przeczytaj także: Wtyczki dla WordPress, które warto zainstalować od razu — lista kontrolna do uruchomienia strony
PHP-FPM: oszczędność na procesach
Nawet jeśli kod był już skompilowany, a część danych — zcache'owana, pozostawał jeszcze jeden problem.
Na początku PHP zazwyczaj działał przez CGI (Common Gateway Interface). Dla każdego żądania HTTP serwer WWW uruchamiał osobny proces PHP, wykonywał skrypt i natychmiast kończył jego działanie. Setki odwiedzających na stronie oznaczały setki nowych procesów, co znacznie zwiększało obciążenie.
Pierwszym krokiem był FastCGI. Jego pomysł był prosty: nie uruchamiać PHP na nowo dla każdego żądania. Zamiast tego serwer utrzymywał kilka już gotowych procesów PHP i po prostu przekazywał im nowe żądania.
Z czasem w PHP pojawił się PHP-FPM (FastCGI Process Manager) — menedżer procesów, który automatycznie tworzył, kończył i skalował pulę procesów PHP w zależności od obciążenia.
W rezultacie serwer przestał marnować zasoby na ciągłe tworzenie nowych procesów i mógł znacznie efektywniej obsługiwać dużą liczbę jednoczesnych odwiedzających.
Izolacja sąsiadów na wspólnym serwerze
W hostingu współdzielonym setki stron działają na jednym serwerze i korzystają ze wspólnych zasobów. Jeśli jedna z nich nagle otrzymywała duży wzrost ruchu lub uruchamiała nieudany skrypt, mogło to wpłynąć na wszystkich sąsiadów.
W 2010 roku firma CloudLinux pod przewodnictwem Igora Seletskiego zaproponowała rozwiązanie. Chociaż mechanizmy izolacji procesów w Linuxie już istniały, CloudLinux dostosował je do potrzeb dostawców hostingu. Technologia LVE (Lightweight Virtual Environment) pozwoliła ustalać osobne limity na procesor, pamięć, dysk i liczbę procesów dla każdego konta.
Po tym problematyczna strona mogła spowolnić tylko siebie, a serwer nadal działał normalnie. W tym miejscu hoster może zaproponować dokupienie zasobów dla konta, które systematycznie odczuwa przeciążenie.
Co to daje dla optymalizacji
Teraz będzie ilustracyjny model. Poprosiłam AI, aby oszacowało, ile zasobów strona mogłaby zużywać BEZ optymalizacji, gdyby działała z nowoczesną grafiką, katalogami i wtyczkami. To nie są dokładne liczby, ponieważ wszystko zależy od tego, jaka CMS jest na stronie, jakie wtyczki, ile osób tam chodzi itp. Ale rząd wielkości może być podobny.
Weźmy hipotetyczną popularną stronę informacyjną z milionem odsłon dziennie. To średnio około 12 odsłon na sekundę, ale podczas szczytów może być dziesięć razy więcej.
Załóżmy, że bez jakichkolwiek optymalizacji tworzenie jednej strony CMS zajmuje około 300 milisekund. W tym czasie wchodzi wykonywanie kodu PHP, działanie wtyczek, odwołania do bazy danych i generowanie HTML.
W ciągu doby to wyniesie:
1 000 000 × 0,3 sekundy = 300 000 sekund, czyli około 83 godziny łącznego czasu przetwarzania żądań.
Teraz wyobraźmy sobie, że strona korzysta z nowoczesnego stosu optymalizacji.
- 95% stron jest oddawanych bezpośrednio z cache strony i wymaga tylko 2 milisekund na przetworzenie.
- Pozostałe 5% są naprawdę generowane przez CMS, ale dzięki OPcache, cache obiektów i PHP-FPM ich przetwarzanie zajmuje około 100 milisekund.
Średni czas przetwarzania jednego żądania wyniesie wtedy:
95% × 2 ms + 5% × 100 ms = 6,9 ms.
Przy milionie odsłon to już:
1 000 000 × 0,0069 sekundy = 6 900 sekund, czyli około 1,9 godziny łącznego czasu przetwarzania żądań.
W tym uproszczonym modelu różnica wynosi ponad 40 razy.
W pieniądzach różnica może wyglądać nie jak „serwer za 50 USD w porównaniu do serwera za 2 USD”, ponieważ do kosztów wchodzą pamięć, baza danych, dyski, rezerwacja, sieć i zdolność do znoszenia szczytów. Niemniej jednak rząd wielkości jest wymowny: bez tych optymalizacji popularna strona CMS mogłaby potrzebować farmy z dziesiątkami rdzeni serwerowych, podczas gdy zoptymalizowana wersja obejmuje się kilkoma.
Przeczytaj także: TOP-3 CMS do tworzenia sklepu internetowego
To pozwala hostować zwykłe nowoczesne strony, które w rzeczywistości cały czas wykonują mnóstwo zadań, na tanich małych hostingach, a użytkownicy — otrzymywać odpowiedź strony w ciągu sekund, a nie godzin, jak to było kiedyś, gdy strona była przeciążona. Ochrona nie działa zawsze idealnie. Wciąż możemy zablokować stronę w dniu sprzedaży upragnionych biletów, zamówienia oczekiwanej książki czy jeśli pojawiła się jakaś gorąca wiadomość. I mimo to w większości przypadków serwery radzą sobie nawet z dużym napływem odwiedzających, którzy masowo coś zamawiają lub przewijają.
Trudno nawet wyobrazić sobie, ile zasobów łącznie oszczędzają codziennie. Co prawda, teraz pojawiła się sztuczna inteligencja, która zużywa ogromne ilości energii, kart pamięci i wody do chłodzenia. Ale prawdopodobnie jej rozwój również będzie zmierzał w kierunku optymalizacji. Albo nie?